
A Japanese benchmark measures laya-mlx and Core ML on six classification tasks
@mizorewww 感谢分享!我在日文文章中引用并嵌入了这条帖子,整理了 MLX/Core ML 的测量条件,并补充了6例日语分类的 CPU 实测。开发者报告值与我的测量结果分别标明:
Seen on X
Demos, games, ports and benchmarks posted on X, picked by hand. Each one links back to the original post and, where there is one, to the project in the directory.
@mizorewww 感谢分享!我在日文文章中引用并嵌入了这条帖子,整理了 MLX/Core ML 的测量条件,并补充了6例日语分类的 CPU 实测。开发者报告值与我的测量结果分别标明:
Pairing LLM calls with a classifier is indeed a great way to make AI (now SI) applications. I replaced a few LLM calls in a project with Laya-mlx and it resulted in improved performance in terms of response time with no downgrade in output quality. #laya #jev #mlx

Laya is the MOST POWERFUL open-source decision model you can run on your own machine right now. Same three question types as Jev: pick one, rate on a scale, yes or no. 100+ languages, about 33 ms per decision, and your text never leaves your machine. 29.5k stars on GitHub. Here is how you set it up: 1. python -m pip install laya (Python 3.10 or newer) 2. from laya import Router, then router = Router(). It downloads a checkpoint on first use 3. router.predict(state, questions) with choice, score or noul questions 4. Non-English text goes to laya-multilingual on its own 5. Command line: laya "My payment failed twice" --preset triage 6. Long documents: model="multilingual", max_len=8192 7. Extras when you need them: laya[serve] for an HTTP server, laya[mcp], laya[langchain] 8. Standards: on their own benchmark the base English checkpoint scores 0.362 and a fine-tuned one 0.766, so fine-tune on your decisions before you trust it Bookmark this.

Run Laya typed decisions locally on Apple Silicon with Core ML and the Neural Engine. - Returns probabilities for choice, score and boolean questions - Runs offline after one-time model download, no PyTorch needed On GitHub → mizorewww/laya-coreml
在苹果电脑上跑 AI,很多框架对苹果芯片支持不好。 Laya MLX 是专门给苹果 MLX 做的运行时,把决策模型重算压到 7–14 毫秒。
Project: laya-mlx→Microsoft-Decision-1が出たので追加で検証してみた。 正解率 ・TypeSafe Jev: 94.1% ・Microsoft-Decision-1: 93.9% ・Laya multilingual(ローカル): 63.4%
⚡️ A New Look at laya-mlx: What the Repository Tells Us + Video -Fact Checker: ✅: 2 ❌: 2 || 2/4 → Score: 50% ⚖️ -Prediction: 📈 2 Positive | 📉 1 Negative

laya-mlx is an open source project that turns Laya typed decision models into fast local answers on Apple Silicon Macs. It runs on MLX with no PyTorch or cloud API. See the code and demo at
Project: laya-mlx→بدون زنجیره استدلال طولانی بدون توکنهای اضافی فقط جوابهای تمیز و سریع. من مدل پایه convaiinnovations/laya-multilingual رو روی یه سری دیتاست ترجمه شده فارسی شامل خردهفروشی، احساسات، اسپم و پشتیبانی فاین تیون کردم و خلاصه بگم که نتایج خیلی خوب بود، بهتر از Jev-1.13. \2

2 open decision models ran 30 support tickets on our 8-core cloud CPU. Strands Decider 2B got 82 of 90 answers right. Laya got 73 of 90. Cost for both: $0.
30 tickets for a made-up candle shop, answer key hashed before either model ran. 1 run each, Oct 9. Route: 24 vs 23 of 30. Refund: 30 vs 29. Urgency 0-3: 28 vs 21. Decider ran in bf16.
Project: laya→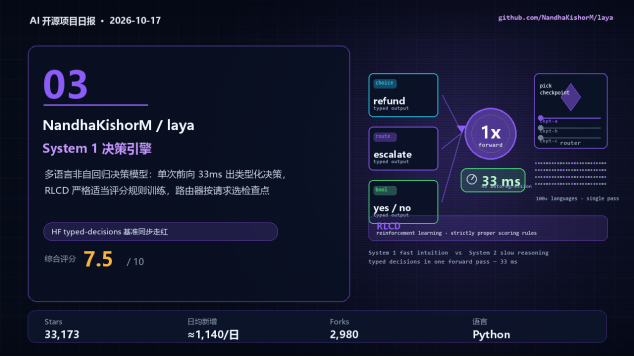
03. NandhaKishorM/laya —— System 1 决策引擎(新品类) 项目简介:Multilingual, non-autoregressive System 1 decision engine. Typed decisions over 100+ languages in a single forward pass — 33 ms — trained with reinforcement learning against strictly proper scoring rules (RLCD), with a router that picks the right checkpoint per request. 中文一句话:不逐字生成的「快思考」模型——输入一个问题,一次前向传播(33ms)直接产出类型化决策(选择 / 评分 / 是否),覆盖 100+ 语言;用严格适当评分规则做强化学习训练,保证校准质量;请求进来先由路由器挑选合适的检查点。配套完整:PyPI 包、在线文档、Colab、HF 模型(laya / laya-multilingual)与 Demo Space;姊妹项目 mizorewww/laya-mlx 提供 Apple Silicon 原生 MLX 运行时,短决策 7-14ms。 技术视角:作者在 自述「一年前做出非自回归决策模型,然后一个前沿实验室把它叫做 System 1」——今天 GitHub + HF 双端走红,说明「决策模型」正在从生成式 LLM 中正式分家。逻辑很硬:Agent 流水线里大量步骤是分类、路由、分诊、打分,用自回归 LLM 做这些事又慢又贵又不可校准;laya 这类模型的卖点是固定延迟 + 类型安全 + 评分规则校准,还能按请求路由检查点。HF 上 LocalLLaMA/typed-decisions(48.2K 下载的 Benchmark)就是给它这类模型准备的考卷。需要盯的:决策质量对小模型的天花板、以及「System 1」叙事下的实际采用深度——目前热度里含大量尝鲜成分。 项目链接:
Project: laya→
🚀 First decision models for Lithuanian medical texts are here! We lead by @dxlino released three open models for calibrated typed decisions on Lithuanian MEDLINE abstracts: - - -
@lgtmboss i got a 1.25x geometric mean speedup over tuned python laya-mlx across 12 workloads, all on my base m5 1,498/1,500 answers matched upstream fp32. the other 2 were near ties full benchmarks are in the repo!

On device AI on Apple Silicon in 2026 📱⚡ Laya CoreML runs typed decisions (choice, score, yes or no) in under 10 ms on the Apple Neural Engine. Zero cloud, zero per inference cost, complete data privacy. Complete 2026 guide:

🔥AI 开源速报 2026.10.23|Agent 迎来完整应用层 ・VectorCraft⭐10.4k:Rust 原生矢量画布,MCP 服务直驱,Agent 可直接做矢量设计,Fork 率高达 48.9% ・iPhone‑use⭐4.5k:通过 USB 让 AI 操控真实 iPhone,实现点开 App、点击、输入等手机自动化 ・laya‑mlx⭐7k:把类型化决策模型移植 Apple Silicon,本地推理低至 13.4ms,零输出 Token ・OpenMuse⭐5.4k:可自托管个人 Agent 客户端,iOS/Android/Web 三端,支持后台过夜运行 ・herdr‑gpui⭐1.6k:Herdr Agent 运行时 Rust 原生跨平台控制台,支持工作区存档与跨主机迁移 📌洞察:工具、外设、运行时、客户端、控制台齐全,Agent 从底层基建走向完整应用生态。 #AIOpenSource #AIAgent #MCP #AppleSilicon
RAGでLLMに任せている判断(ツール・検索対象データの選択、問い返し等19種)を判断専用モデルに置き換えられるか、日本語137問で検証してみた。 正解率 ・TypeSafe Jev: 94.1% ・Microsoft-Decision-1: 93.6% ・gpt-6-luna: 89.3% ・Laya multilingual: 63.4% #MicrosoftFoundry #AzureOpenAI
嫌TypeSafe贵?本地判决五产线: 1️⃣自训厂长kev 9836★:Qwen训0.8-27B⚠️勿pip须源码 2️⃣苹果极速机laya-mlx 7068★:M3Max短判7ms 3️⃣语义ifSemIf-OpenJev 4931★:直读logits比JSON快5倍 4️⃣纳米仿制厂NanoJev 2579★:0.6B并行 5️⃣套壳判官AnyJev 1586★:免训秒变L0判官
À l'origine en anglais et traduit Maya a1 : Les options lisent-elles le modèle, ou leur position ? Sensibilité à l'ordre dans un modèle de décision non autorégressif : "Maya a1 : Les options lisent-elles le modèle, ou leur position ? Sensibilité à l'ordre dans un modèle de décision non autorégressif Quantification de la dépendance à l'ordre des options dans Laya et suppression de la plupart d'entre elle par un fine-tuning mélangé Mohammed Nayeem Khan [email protected] [email protected] Logesh L [email protected] Intel Corporation v0.2 · 6 novembre 2026 · arXiv (liste croisée cs.LG) · artefacts : tasks/maya (code, résultats figés, modèles, hachages) Résumé Laya répond aux questions à choix multiples tapées en un seul passage avant par la notation d'un état caché à un marqueur [MASK] par option. Nous ré-ingénierons le point de contrôle (421M paramètres ; une tête d'option à 2 couches sans tenseur positionnel ; une disposition parallèle documentée mais inutilisée) et testons si la réponse dépend de l'endroit où une option est listée. Présentant 951 questions vérifiées par Qwen sous chaque rotation cyclique de leurs options (ou six permutations aléatoires pour 12 options), le point de contrôle publié change sa réponse pour 25,8 % [22,9–28,7] des questions (19,7 % sur les 605 éléments en langue anglaise uniquement) ; la précision avec l'option or premier versus dernier diffère de 10,1 %, et les basculements se concentrent là où la confiance propre du modèle est faible (54 % versus 8 % à travers les terciles de confiance). Le fine-tuning avec l'entraîneur de Laya sur 2 818 lignes vérifiées par l'enseignant avec mélange d'options réduit le taux de basculement à 7,2 % ; les lignes identiques sans mélange donnent 11,4 %, donc le mélange est responsable de 4,2 % de l'amélioration. Un vote pondéré par la confiance sur les ordre donne 69,7 % contre 69,1 % pour un seul passage de base à 4,1× le calcul. Les étiquettes sont faites par LLM et les ensembles de test sont filtrés par l'enseignant. Nous fine-tunons également avec la disposition parallèle des auteurs sur les mêmes lignes : taux de basculement 0,5 %. Mots-clés : modèles de décision non autorégressifs ; Laya ; ré-ingénierie ; calibration ; supervision générée par LLM ; fine-tuning. Résultats clés (chaque nombre recalculé à partir de résultats figés) 1. Taux de basculement de base 25,8 % [22,9–28,7] ; Maya-v1 7,2 % ; mêmes lignes sans mélange 11,4 %. 2. Écart de précision or-premier vs or-dernier 10,1 % (base) ; taux de basculement par tercile de confiance 54 % / 16 % / 8 %. 3. Vote pondéré par la confiance (base) : 69,7 % vs 69,1 % passage unique, à 4,1× calcul ; Maya-v1 passage unique : 86,3 %. 4. La dépendance à la position est reconnue en amont (docstring de Laya : logits de fente de cinq options identiques étalés par 3,59). Disposition parallèle des auteurs, adaptée sur les mêmes lignes : taux de basculement 0,5 %. 1 Introduction 2 Contexte et travaux connexes 3 Ré-ingénierie de Laya 4 Données, protocole et statistiques 5 Résultats : Laya est-elle sensible à l'ordre ? 6 Isolement du prior positionnel 7 Correctif : fine-tuning avec mélange d'options 8 Tableau de bord des hypothèses 9 Validité des étiquettes et comparaison avec un LLM 10 Puissance statistique et sensibilité du verdict 11 Effets collatéraux et coût d'inférence 12 Analyse des erreurs 13 Discussion et conseils de déploiement 14 Menaces à la validité 15 Limitations et travaux futurs 16 Explications alternatives 17 Éthique et impact plus large 18 Conclusion Annexe A Prompts et catégories Annexe B Schémas de questions et exemples d'éléments Annexe C Comparaison complète des modèles Annexe D Définitions des métriques Annexe E Reproductibilité Références 1 Introduction Un modèle de décision qui lit les textes des options devrait donner la même réponse lorsque les mêmes options sont listées dans un ordre différent. Laya est un encodeur non autorégressif qui répond aux questions tapées en un seul passage avant ; pour une question à choix il ajoute un marqueur [MASK] par option à la question et note l'état caché à chaque marqueur. Les options sont donc disposées le long d'une seule séquence, et rien dans les poids ne garantit qu'une position d'option est sans rapport. Nous mesurons cela sur 951 questions à choix vérifiées par Qwen tirées de sept catégories (3, 5 et 12 options), présentant chaque question sous chaque rotation cyclique de ses options (K≤5) ou six permutations aléatoires (K=12), c.-à-d. 3 893 appels de modèle par point de contrôle. Questions de recherche. RQ1 : le point de contrôle publié change-t-il sa réponse sous réorganisation, et dans quelle mesure ? RQ2 : quelle est la forme de la dépendance (fente, nombre d'options, catégorie, confiance) ? RQ3 : un remède sans entraînement (vote sur les ordres) est-il compétitif ? RQ4 : le fine-tuning sur des lignes vérifiées par Qwen avec mélange d'options supprime-t-il la dépendance, et dans quelle mesure l'effet est-il dû au mélange lui-même plutôt qu'aux données supplémentaires ? RQ5 : le résultat est-il stable à travers les graines d'entraînement ? Contributions. (i) Sur le point de contrôle de base 25,8 % [22,9–28,7] des questions changent leur réponse purement parce que les options ont été réorganisées (19,7 % sur les 605 éléments en langue anglaise uniquement). (ii) La dépendance n'est pas un artefact premier/dernier seul : l'écart de précision premier-vs-dernier est de 10,1 %, mais les prédictions se concentrent dans des fentes particulières (distance de variation totale par rapport à l'uniforme 0,09 à K=3, 0,07 à K=12). (iii) Le fine-tuning avec mélange réduit le taux de basculement à 7,2 %, tandis que les mêmes lignes sans mélange donnent 11,4 %. (iv) La confiance est un détecteur informatif des basculements (taux de basculement 54 % / 16 % / 8 % à travers les terciles de confiance) et un vote pondéré par la confiance sur les ordres donne 69,7 % versus 69,1 % pour un seul passage de base, à 4,1× calcul. (v) Nous fine-tunons également avec la disposition parallèle des auteurs sur les mêmes lignes : taux de basculement 0,5 %. 2 Contexte et travaux connexes Biais de position dans les modèles génératifs. L'évaluation à choix multiples des LLM décodeurs est connue pour dépendre de l'endroit où la réponse est listée : les modèles préfèrent des ID ou positions d'options particulières, et la précision bouge de plusieurs points lorsque les options sont permutées [Zheng et al. 2023 ; Pezeshkpour et Hruschka 2023] ; les juges LLM préfèrent la première réponse montrée [Wang et al. 2023]. La compétition de forme de surface [Holtzman et al. 2021] ajoute que la masse de probabilité est étalée sur des chaînes, pas des options. Ces analyses concernent des modèles qui génèrent une étiquette d'option ; Laya ne génère pas, il lit un état caché par option, donc le mécanisme, et les remèdes disponibles, diffèrent. Architectures invariantes à l'ordre. Les encodeurs de style ensemble évitent l'ordre par construction. Les auteurs de Laya ont identifié le problème dans leur propre code : une docstring indique que dans la disposition séquentielle « les logits de fente de cinq options identiques s'étalent par 3,59 » et le dépôt contient une disposition parallèle inutilisée qui partage les id de position à travers les options et masque l'attention croisée-option. Cet article ne remplace pas cet effort ; il demande quelle est l'ampleur de l'effet sur des questions réalistes, à quoi il ressemble, et si les données seules (mélange d'options pendant le fine-tuning) en suppriment la plupart. Effets positionnels et de forme de surface au-delà des LLM. Les effets d'ordre d'options ne sont pas confinés aux LLM décodeurs. Dans la compréhension lecture à choix multiples avec encodeurs fine-tunés, la position de réponse est un artefact fréquent de la construction de dataset ; ici la construction de dataset est uniforme par design (chaque option est or également souvent dans chaque fente), donc tout effet que nous mesurons appartient au modèle. Dans l'évaluation LLM, l'atténuation standard est de moyenner sur les permutations à l'inférence [Zheng et al. 2023 ; Wang et al. 2023] ; nous testons cela (Section 5.6) aux côtés d'une atténuation à l'entraînement et d'une architecturale. Pourquoi une étude séparée pour un modèle non génératif. Les atténuations proposées pour les modèles génératifs, comme débiaiser le prior sur les ID d'options, supposent une distribution de probabilité sur les tokens de réponse. Laya n'a pas une telle distribution : il a un logit scalaire par fente. Les questions pertinentes sont donc différentes : le logit est-il une fonction du texte d'option seul, ou de sa position ? La dépendance est-elle apprise de l'ordre d'entraînement ou intégrée dans la machinerie positionnelle de l'encodeur ? La sonde d'options identiques (Section 6) et la comparaison de disposition (Section 7) répondent à ces deux questions séparément. Protocole d'évaluation. Nous suivons la littérature sur l'invariance de permutation en utilisant toutes les rotations cycliques pour petit K (de sorte que chaque option occupe chaque fente exactement une fois) et permutations aléatoires pour grand K, et nous rapportons le taux de basculement (une mesure d'instabilité au niveau élément) à côté de la précision moyenne, parce que la précision moyennée sur les ordres peut cacher que les décisions individuelles changent. Pourquoi un modèle non génératif pourrait encore être biaisé par la position. Les encodeurs avec information de position (absolue ou rotative) peuvent apprendre des raccourcis dépendants de la position chaque fois que la fréquence d'étiquette corrèle avec la position pendant l'entraînement. Dans la recette d'entraînement propre de Laya les options sont présentées dans l'ordre que la question les liste sauf si le drapeau opt-in --shuffle-options est utilisé (docstring de l'entraîneur de Laya : « Les scripts présentent toujours les options dans l'ordre que la question les liste, donc le modèle peut apprendre un prior positionnel »). Notre processus de génération de données rend les étiquettes or uniformes sur les fentes par construction, donc tout prior positionnel que nous mesurons est une propriété des poids publiés, pas de nos données. 3 Ré-ingénierie de Laya 3.1 L'artefact L'inspection d'en-tête du fichier safetensors énumère 206 tenseurs et 421 293 830 paramètres (842 609 210 octets). 93,7 % des paramètres sont l'encodeur ; la machinerie de décision au-dessus (tête, scoreur, act head, embeddings de type) n'est que 6,3 %. Tableau RE-1. Groupes de tenseurs de convaiinnovations/laya/model.safetensors tels qu'énumérés à partir de l'en-tête de fichier (tous F16 sauf température, F32). Groupe Tenseurs Paramètres Part Rôle (inféré des noms et du runtime open-source) encoder 170 394 781 696 93,7 % ModernBERT-large : 28 couches, caché 1024, vocabulaire 50 368 head 24 25 192 448 6,0 % 2 couches transformer post-encodeur (self-attention + FFN de 4096 large) sur les états fente-option scorer 6 1 052 673 0,2 % LayerNorm → linéaire → scalaire : un logit par fente option act_head 4 263 938 0,1 % petit MLP (1028→256→2) qui produit la probabilité ‘act’ type_emb 1 3 072 0,0 % un embedding chacun pour choice / score / noul, ajouté aux états fente température 1 3 <0,01 % trois scalaires F32, un par type de question (tous 1.0 dans le fichier de base ; les valeurs live sont dans la config JSON) 3.2 Configuration Tableau RE-2. Clés de configuration du point de contrôle de base qui importent ici (rl_agent_config.json). Clé Valeur Conséquence encoder answerdotai/ModernBERTlarge positions rotatives ; pas de table de position absolue apprise à inspecter max_len 512 tokens totaux : tête + état head_max_len 192 tokens disponibles à instruction + toutes les options head_layers 2 états fente échangent de l'information par self-attention option_layout séquentiel (défaut) tous les points de contrôle publiés utilisent la disposition séquentielle température 1.637, 1.251, 1.983 rappels par-type (choice, score, noul) température_par_options[choice:3-5] 1.7602 appliquée après clampage à [0.5, 5] température_par_options[choice:6- 10] 1.0000 appliquée après clampage à [0.5, 5] température_par_options[score:3-5] 1.2514 appliquée après clampage à [0.5, 5] température_par_options[noul:2] 1.9834 appliquée après clampage à [0.5, 5] température_par_options[choice:11+] 0.1006 appliquée après clampage à [0.5, 5] — clampée de 0.1006 à 0.5 ; encore un aiguisoir 2× température_par_options[choice:2] 1.9064 appliquée après clampage à [0.5, 5] 3.3 Chemin d'exécution Nous lisons le runtime open-source (laya 0.4.26) aux côtés des poids ; le chemin de la requête à la probabilité est : 1. Agent.predict_batch ( ~L1486) groupe les états qui partagent un ensemble de questions et tokenize chaque état une fois. 2. build_head / build_sequence ( L157–L270) rend [CLS] question: [SEP] [MASK] opt0 … [MASK] optK−1 [SEP] [SEP] ; chaque texte d'option est plafonné à 48 tokens, la tête à head_max_len, et l'état est coupé à droite pour s'ajuster à max_len (truncate_left=False). 3. L'encodeur s'exécute une fois. L'état caché à chaque marqueur [MASK] d'option est pris comme état fente de cette option ; l'embedding de type est ajouté et la tête à 2 couches laisse les fentes s'attendre mutuellement. 4. Le scoreur émet un logit par fente. Pour choice les logits sont divisés par la température du seau (temp_bucket(type, K), clampé à [0.5, 5]) et soft-maxé ; score utilise le même softmax et rapporte un niveau attendu ; noul rapporte la probabilité de la seconde fente. 5. unpermute_probs mappe les probabilités en arrière si l'appelant a fourni option_order ; le résultat porte answer_confidence (la probabilité top) et une confiance basée sur l'entropie séparée qui n'est explicitement pas calibrée. Figure RE-1. Le chemin de décision de Laya tel que reconstruit à partir de l'inventaire des tenseurs et du runtime open-source. Rouge : les deux endroits où les études de cette série trouvent des problèmes (dépendance positionnelle à travers l'encodeur ; la température par nombre d'options). Note sur la disposition parallèle inutilisée. uses_parallel_layout(cfg) lit option_layout de la config et défaut à séquentiel ; la config de base n'a pas une telle clé. La docstring dans dit qu'un point de contrôle entraîné sur une disposition lit l'autre « comme une entrée différente », donc changer de disposition nécessite un entraînement, ce qui est hors de cet article. Provenance. Preuve d'inspection d'en-tête ev_2648a4101f7787d1303a… (base, SHA-256 fichier complet 891102d372688fc2a094dac56a384bc537b87c63f21f9f3dac0be2b7cbc8d86c) et ev_fbf433f9d808bc103606… (Maya-v1, 632868e784f96b313cb48cefa996dd78a392d27b056cf2a69d6798deb9ddab7c). Les noms, formes et dtypes de tenseurs des deux fichiers sont différents : toutes nos corrections changent les valeurs de poids et (pour certaines) la config JSON, jamais l'architecture. L'inspection rapporte seulement des faits d'en-tête déclarés ; elle n'exécute pas le modèle, donc tout ce qui est comportemental ci-dessous est mesuré en boîte noire. 3.4 Hypothèses de la ré-ingénierie H1 (la position entre par l'encodeur). La tête n'a pas de tenseur d'embedding positionnel (Tableau RE-1 n'en liste aucun) : ses deux couches sont équivariantes de permutation sur les fentes, et l'embedding de type est le même pour chaque fente. La seule façon dont la position d'une option peut influencer son logit est à travers l'encodeur, dont les positions rotatives placent chaque marqueur [MASK] à un offset différent dans la disposition séquentielle. Prédiction : les réponses changent sous réorganisation bien que les textes d'option soient identiques. H2 (l'effet est le plus grand pour la première et dernière fente et pour beaucoup d'options). L'attention rotative rend le premier marqueur adjacent à l'instruction et le dernier adjacent à l'état ; les deux sont privilégiés. Prédiction : une courbe de précision en U sur la fente or, la plus forte à K=12. H3 (le fine-tuning mélangé est suffisant). Si la dépendance est apprise plutôt qu'architecturale, présenter les options dans un ordre aléatoire pendant le fine-tuning devrait la supprimer sans toucher la disposition. Prédiction : v1 bascule beaucoup moins que l'ablation noshuffle entraînée sur des lignes identiques. 4 Données, protocole et statistiques 4.1 Données retenues d'un enseignant LLM Figure M-0. Conception de l'étude. Les boîtes vertes sont les vérifications de validité ajoutées après les premiers brouillons : une famille LLM indépendante ré-étiquette chaque élément de test, et une base classique est entraînée sur exactement les mêmes lignes. Nous ne pouvons pas livrer des ensembles de test étiquetés par humains pour ces lacunes, donc nous les générons. Pour chaque catégorie un prompt demande à Qwen3.8-27B (pensée désactivée) dix entrées réalistes dont la réponse correcte est une étiquette déclarée, avec des indices de catégorie (par exemple, « chaque texte doit contenir une négation »). Un second appel indépendant est montré les mêmes entrées sans l'étiquette destinée et demandé de choisir ; toute entrée sur laquelle les deux appels sont en désaccord est jetée. Les prompts exacts sont en Annexe A. Le filtre supprime les entrées ambiguës pour l'enseignant, mais il supprime aussi des cas durs-mais-valides, et il ne peut pas supprimer les erreurs que l'enseignant fait de manière consistante. Les ensembles de test mesurent donc l'accord avec Qwen, pas la vérité de terrain humaine ; nous revenons à cela dans la section menaces de chaque article. Tableau M-1. Candidats écrits par Qwen3.8-27B, et combien survivent au passage de ré-étiquetage aveugle (accord générateur-vs-ré-étiqueteur). Catégorie Généré Conservé Accord hw_failure 100 82 82,0 % json_state 90 58 64,4 % many_hr 773 716 92,6 % many_options 240 195 81,2 % mix_Arabizi 60 53 88,3 % mix_Hinglish 60 58 96,7 % mix_Spanglish 60 47 78,3 % sentiment_clean 111 106 95,5 % urgency 477 229 48,0 % ml_* (12 langues) 1 420 1 289 90,8 % Tableau M-2. Divisions de données (lignes après dé-duplication). Division Lignes Utilisation train 2 818 fine-tuning (tous les variants Maya) probe 224 premier scan de lacune ; rapporté avant/après par laya-train Division Lignes Utilisation sent_test 106 retenu : sentiment, injection, contexte long json_test 58 retenu : tickets JSON hw_test 82 retenu : défaillance de validation hardware many_test 195 retenu : question 12-thèmes ml_test 322 retenu : 12 langues urg_test 78 retenu : urgence (score) ml_train / urg_train 967 / 151 lignes extra utilisées seulement par les variants multilingue / urgence 4.2 Entraînement Chaque modèle Maya est Laya fine-tuné avec son propre entraîneur et perte (RLCD : un terme de style policy-gradient sur des échantillons de logit bruyants récompensés par une règle de notation propre, plus cross-entropie douce), donc les seules variables expérimentales sont les lignes d'entraînement et (où indiqué) la graine. L'entraînement prend des minutes sur un GPU consommateur unique. Tableau M-3. Recette de fine-tuning (laya-train ; identique pour chaque variant sauf indiqué). Paramètre Valeur epochs 4 micro_batch 8 grad_accum 8 encoder_lr 2.5e-05 head_lr 0.0001 min_lr 1e-06 weight_decay 0.01 grad_clip 1.0 loss rlcd rl_samples 4 sigma_start 0.4 sigma_end 0.1 w_sph 0.75 w_rps 1.0 mélange d'options activé pour les questions choice (désactivé seulement dans l'ablation no-shuffle) calibration holdout taillé de les données d'entraînement par laya-train (ajuste les températures ; jamais les ensembles de test) hardware / software 1× RTX 4090 (24 GB), torch 2.11.0+cu128, transformers 5.20.2, laya 0.4.26 graine 0 sauf si une graine est nommée 4.3 Statistiques Les proportions portent des intervalles Wilson 95 % [Wilson 1927]. Deux modèles sur les mêmes éléments sont comparés avec le test exact bilatéral McNemar [McNemar 1947]. Les taux qui ne sont pas par correction d'élément (taux de basculement, ECE) utilisent un bootstrap au niveau ligne avec 1 000 rééchantillons (300 où une statistique est chère) [Efron et Tibshirani 1993]. Nous utilisons α=0.01 et un effet pratique minimum de 5 points, fixé avant que les résultats de correctif soient calculés (voir ; pas de correction de multiplicité appliquée à travers les dix lacunes scannées, c'est pourquoi nous requérons à la fois une petite p-valeur et un effet non trivial. ECE utilise 10 bacs de largeur égale sauf indiqué. 4.4 Audit de fuite Les doublons exacts entre lignes de test et d'entraînement sont supprimés pendant la génération. Pour vérifier les quasi-doublons nous avons calculé, pour chaque élément de test, la similarité Jaccard caractère-5-gramme à sa ligne d'entraînement la plus similaire. Similarité médiane maximale est 0,08–0,15 à travers les ensembles, et 0,1 % des éléments atteignent en moyenne 0,5 (pire ensemble : 0,5 %). La précision sur le sous-ensemble de faible similarité égale la précision globale à 0,0 points près, donc nous ne trouvons aucun signe que les gains viennent de voisins mémorisés. 4.5 Protocole de sensibilité à l'ordre Les questions sont prises de chaque ensemble de test dont le type de question est choice avec K≥3 (951 éléments ; catégories dans Tableau 2). Pour K≤5 les options sont rotées cycliquement, donnant K ordres dans lesquels chaque option apparaît dans chaque fente une fois ; pour K=12 six permutations aléatoires sont tirées une fois (graine 1) et réutilisées pour chaque élément et chaque modèle, donc tous les modèles voient des présentations identiques. Le taux de basculement est la fraction d'éléments dont l'option prédite diffère à travers les ordres. La précision fente-or moyenne la correction sur toutes les paires (élément, ordre) dans lesquelles l'option or siège dans une fente donnée. La précision de vote compte un élément comme correct seulement si l'option or est la réponse pluralité unique sur les ordres. Le taux de basculement a un plancher non zéro sur les éléments ambigus, donc nous comparons toujours les modèles sur des éléments identiques et utilisons l'ablation no-shuffle comme contrôle apparié. 5 Résultats : Laya est-elle sensible à l'ordre ? 5.1 Manchette Tableau 1. Sensibilité à l'ordre sur 951 questions choice (K≥3), et sur les 605 éléments en langue anglaise seulement (les 12 catégories de langue native sont exclues dans la troisième colonne parce que la racine anglaise est proche de deviner sur elles). Taux de basculement : réponse change sous au moins un réordre. Moy. acc. : précision moyennée sur tous les ordres. Préc. vote : vote pondéré par confiance sur tous les ordres (coûte K× calcul). Modèle Taux de basculement, tous [IC 95 %] Taux de basculement, anglais seulement Moy. acc. Préc. vote Laya (root) 25,8 % [22,9–28,7] 19,7 % [16,5–22,8] 69,1 % 69,7 % Laya typed-decisions 12,5 % [10,3–14,7] 12,9 % [10,2–15,5] 71,0 % 71,8 % Laya-multilingual 19,2 % [16,9–21,7] 26,0 % [22,5–29,4] 67,4 % 67,7 % Maya-v1 s/o mélange options 11,4 % [9,5–13,6] 8,3 % [6,1–10,6] 86,6 % 87,2 % Maya-v1 7,2 % [5,7–8,9] 4,5 % [3,0–6,1] 86,3 % 86,2 % Maya + disposition parallèle (correctif architectural des auteurs) 0,5 % [0,1–1,1] 0,3 % [0,0–0,8] 86,0 % 85,9 % Maya + augmentation nom 8,2 % [6,5–9,8] 6,0 % [4,1–7,8] 86,8 % 87,5 % Le point de contrôle root bascule sur 25,8 % [22,9–28,7] de toutes les questions (critère de lacune — borne inférieure >10 % : rempli). Les catégories de langue native (36 % des éléments) sont beaucoup moins stables (36,4 % basculement) parce que la racine anglaise est proche de deviner sur elles ; les excluant, la root bascule sur 19,7 % [16,5–22,8] de 605 éléments anglais, donc la lacune tient sur le texte anglais seul. Le fine-tune typed-decisions des auteurs bascule sur 12,5 % (anglais seulement : 12,9 %), et le point de contrôle multilingue livré sur 19,2 %, donc l'effet n'est pas spécifique à un point de contrôle. 5.2 Par catégorie et nombre d'options Tableau 2. Par catégorie : nombre d'options K, éléments, taux de basculement (base / ablation no-shuffle / Maya-v1) et précision moyenne (base / Maya-v1). Catégorie K n Basc. base Basc. no-shuffle Basc. v1 Acc base Acc v1 hw_failure 5 115 33,0 % 10,4 % 4,3 % 61,9 % 96,9 % injection 3 21 9,5 % 4,8 % 4,8 % 88,9 % 96,8 % json_state 3 76 6,6 % 1,3 % 0,0 % 66,7 % 89,5 % many_options 12 270 26,7 % 9,6 % 5,9 % 72,8 % 92,6 % ml_Arabic 3 28 60,7 % 21,4 % 28,6 % 38,1 % 51,2 % Catégorie K n Basc. base Basc. no-shuffle Basc. v1 Acc base Acc v1 ml_Bengali 3 26 84,6 % 15,4 % 19,2 % 24,4 % 37,2 % ml_Chinese 3 29 20,7 % 6,9 % 10,3 % 77,0 % 95,4 % ml_German 3 27 11,1 % 0,0 % 3,7 % 85,2 % 97,5 % ml_Hindi 3 27 63,0 % 25,9 % 14,8 % 38,3 % 55,6 % ml_Japanese 3 30 26,7 % 0,0 % 3,3 % 76,7 % 98,9 % ml_Korean 3 21 38,1 % 33,3 % 23,8 % 52,4 % 60,3 % ml..."
Maya a1: Do the Options Read the Model, or Does Their Position? Order Sensitivity in a Non-Autoregressive Decision Model : "Maya a1: Do the Options Read the Model, or Does Their Position? Order Sensitivity in a Non-Autoregressive Decision Model Quantifying option-order dependence in Laya and removing most of it by shuf led fine-tuning Mohammed Nayeem Khan [email protected] [email protected] Logesh L [email protected] Intel Corporation v0.2 · 6 November 2026 · arXiv (cross-list cs.LG) · artifacts: tasks/maya (code, frozen results, models, hashes) Abstract Laya answers typed multiple-choice questions in one forward pass by scoring a hidden state at one [MASK] marker per option. We re-engineer the checkpoint (421M parameters; a 2-layer option head with no positional tensor; a documented but unused parallel layout) and test whether the answer depends on where an option is listed. Presenting 951 Qwen-verified questions under every cyclic rotation of their options (or six random permutations for 12 options), the released checkpoint changes its answer for 25.8% [22.9–28.7] of questions (19.7% on the 605 English-language items alone); accuracy with the gold option first versus last differs by 10.1%, and the flips concentrate where the model’s own confidence is low (54% versus 8% across confidence terciles). Fine-tuning with Laya’s trainer on 2,818 teacher-verified rows with option shuffling cuts the flip rate to 7.2%; the identical rows without shuffling give 11.4%, so shuffling is responsible for 4.2% of the improvement. A confidence-weighted vote over orderings gives 69.7% against 69.1% for a single base pass at 4.1× the compute. Labels are LLM-made and the test sets are teacher-filtered. We also fine-tune with the authors’ parallel layout on the same rows: flip rate 0.5%. Keywords: non-autoregressive decision models; Laya; re-engineering; calibration; LLM-generated supervision; fine-tuning. Key findings (every number recomputed from frozen results) 1. Base flip rate 25.8% [22.9–28.7]; Maya-v1 7.2%; same rows without shuffling 11.4%. 2. Gold-first vs gold-last accuracy gap 10.1% (base); flip rate by confidence tercile 54% / 16% / 8%. 3. Confidence-weighted vote (base): 69.7% vs 69.1% single pass, at 4.1× compute; single-pass Maya-v1: 86.3%. 4. Position dependence is acknowledged upstream (Laya docstring: slot logits of five identical options spread by 3.59). Authors’ parallel layout, adapted on the same rows: flip rate 0.5%. 1 Introduction 2 Background and related work 3 Re-engineering Laya 4 Data, protocol and statistics 5 Results: how order-sensitive is Laya? 6 Isolating the position prior 7 Fix: fine-tuning with option shuffling 8 Hypothesis scorecard 9 Validity of the labels and comparison with an LLM 10 Statistical power and sensitivity of the verdict 11 Collateral effects and inference cost 12 Error analysis 13 Discussion and deployment guidance 14 Threats to validity 15 Limitations and future work 16 Alternative explanations 17 Ethics and broader impact 18 Conclusion Appendix A Prompts and categories Appendix B Question schemas and example items Appendix C Full model comparison Appendix D Metric definitions Appendix E Reproducibility References 1 Introduction A decision model that reads option texts should give the same answer when the same options are listed in a different order. Laya is a non-autoregressive encoder that answers typed questions in one forward pass; for a choice question it appends one [MASK] marker per option to the question and scores the hidden state at each marker. The options are therefore laid out along a single sequence, and nothing in the weights guarantees that an option’s position is irrelevant. We measure this on 951 Qwen-verified choice questions drawn from seven categories (3, 5 and 12 options), presenting each question under every cyclic rotation of its options (K≤5) or six random permutations (K=12), i.e. 3,893 model calls per checkpoint. Research questions. RQ1: does the released checkpoint change its answer under reordering, and by how much? RQ2: what is the shape of the dependence (slot, option count, category, confidence)? RQ3: is a no-training remedy (voting over orderings) competitive? RQ4: does fine-tuning on Qwen-verified rows with option shuffling remove the dependence, and how much of the effect is due to shuffling itself rather than the extra data? RQ5: is the result stable across training seeds? Contributions. (i) On the base checkpoint 25.8% [22.9–28.7] of questions change their answer purely because the options were reordered (19.7% on the 605 English-language items alone). (ii) The dependence is not a first/last artefact alone: the first-vs-last accuracy gap is 10.1%, but predictions are concentrated in particular slots (total-variation distance from uniform 0.09 at K=3, 0.07 at K=12). (iii) Fine-tuning with shuffling reduces the flip rate to 7.2%, whereas the same rows without shuffling give 11.4%. (iv) Confidence is an informative detector of flips (flip rate 54% / 16% / 8% across confidence terciles) and a confidence-weighted vote over orderings gives 69.7% versus 69.1% for a single base pass, at 4.1× compute. (v) We also fine-tune with the authors’ parallel layout on the same rows: flip rate 0.5%. 2 Background and related work Position bias in generative models. Multiple-choice evaluation of decoder LLMs is known to depend on where the answer is listed: models prefer particular option IDs or positions, and accuracy moves by several points when options are permuted [Zheng et al. 2023; Pezeshkpour and Hruschka 2023]; LLM judges prefer the first response shown [Wang et al. 2023]. Surface-form competition [Holtzman et al. 2021] adds that probability mass is spread over strings, not options. These analyses concern models that generate an option label; Laya does not generate, it reads one hidden state per option, so the mechanism, and the available remedies, differ. Order-invariant architectures. Set-style encoders avoid order by construction. Laya’s authors identified the issue in their own code: a docstring states that in the sequential layout “the slot logits of five identical options spread by 3.59” and the repository contains an unused parallel layout that shares position ids across options and masks cross-option attention. This paper does not replace that effort; it asks how large the effect is on realistic questions, what it looks like, and whether data alone (option shuffling during fine-tuning) removes most of it. Positional and surface-form effects beyond LLMs. Option-order effects are not confined to decoder LLMs. In multiple-choice reading comprehension with fine-tuned encoders, answer position is a frequent artefact of dataset construction; here the dataset construction is uniform by design (every option is gold equally often in every slot), so any effect we measure belongs to the model. In LLM evaluation, the standard mitigation is to average over permutations at inference [Zheng et al. 2023; Wang et al. 2023]; we test that (Section 5.6) alongside a training-time mitigation and an architectural one. Why a separate study for a non-generative model. The mitigations proposed for generative models, such as debiasing the prior over option IDs, assume a probability distribution over answer tokens. Laya has no such distribution: it has one scalar logit per slot. The relevant questions are therefore different: is the logit a function of the option text alone, or of its position? Is the dependence learned from the training order or built into the positional machinery of the encoder? The identical-option probe (Section 6) and the layout comparison (Section 7) answer these two questions separately. Evaluation protocol. We follow the permutation-invariance literature in using all cyclic rotations for small K (so that each option occupies each slot exactly once) and random permutations for large K, and we report the flip rate (an itemlevel instability measure) next to mean accuracy, because accuracy averaged over orderings can hide that individual decisions change. Why a non-generative model could still be position-biased. Encoders with position information (absolute or rotary) can learn position-dependent shortcuts whenever label frequency correlates with position during training. In Laya’s own training recipe the options are presented in the order the question lists them unless the opt-in --shuffle-options flag is used (Laya’s trainer docstring: “The scripts always present options in the order the question lists them, so the model can learn a position prior”). Our data-generation process makes gold labels uniform over slots by construction, so any position prior we measure is a property of the released weights, not of our data. 3 Re-engineering Laya 3.1 The artifact Header inspection of the safetensors file enumerates 206 tensors and 421,293,830 parameters (842,609,210 bytes). 93.7% of the parameters are the encoder; the decision machinery on top of it (head, scorer, act head, type embeddings) is only 6.3%. Table RE-1. Tensor groups of convaiinnovations/laya/model.safetensors as enumerated from the file header (all F16 except temperature, F32). Group Tensors Parameters Share Role (inferred from names and the open-source runtime) encoder 170 394,781,696 93.7% ModernBERT-large: 28 layers, hidden 1024, vocabulary 50,368 head 24 25,192,448 6.0% 2 post-encoder transformer layers (self-attention + 4096-wide FFN) over the option-slot states scorer 6 1,052,673 0.2% LayerNorm → linear → scalar: one logit per option slot act_head 4 263,938 0.1% small MLP (1028→256→2) that produces the ‘act’ probability type_emb 1 3,072 0.0% one embedding each for choice / score / noul, added to the slot states temperature 1 3 <0.01% three F32 scalars, one per question type (all 1.0 in the base file; the live values are in the JSON config) 3.2 Configuration Table RE-2. Configuration keys of the base checkpoint that matter here (rl_agent_config.json). Key Value Consequence encoder answerdotai/ModernBERTlarge rotary positions; no learned absolute position table to inspect max_len 512 total tokens: head + state head_max_len 192 tokens available to instruction + all options head_layers 2 slot states exchange information through self-attention option_layout sequential (default) all published checkpoints use the sequential layout temperature 1.637, 1.251, 1.983 per-type fallbacks (choice, score, noul) temperature_by_options[choice:3-5] 1.7602 applied after clamping to [0.5, 5] temperature_by_options[choice:6- 10] 1.0000 applied after clamping to [0.5, 5] temperature_by_options[score:3-5] 1.2514 applied after clamping to [0.5, 5] temperature_by_options[noul:2] 1.9834 applied after clamping to [0.5, 5] temperature_by_options[choice:11+] 0.1006 applied after clamping to [0.5, 5] — clamped from 0.1006 to 0.5; still a 2× sharpener temperature_by_options[choice:2] 1.9064 applied after clamping to [0.5, 5] 3.3 Runtime path We read the open-source runtime (laya 0.4.26) alongside the weights; the path from request to probability is: 1. Agent.predict_batch ( ~L1486) groups states that share a question set and tokenizes each state once. 2. build_head / build_sequence ( L157–L270) render [CLS] question: [SEP] [MASK] opt0 … [MASK] optK−1 [SEP] [SEP]; each option text is capped at 48 tokens, the head at head_max_len, and the state is cut from the right to fit max_len (truncate_left=False). 3. The encoder runs once. The hidden state at each option’s [MASK] marker is taken as that option’s slot state; the type embedding is added and the 2-layer head lets the slots attend to each other. 4. The scorer emits one logit per slot. For choice the logits are divided by the bucket temperature (temp_bucket(type, K), clamped to [0.5, 5]) and soft-maxed; score uses the same softmax and reports an expected level; noul reports the probability of the second slot. 5. unpermute_probs maps probabilities back if the caller supplied option_order; the result carries answer_confidence (the top probability) and a separate entropy-based confidence that is explicitly not calibrated. Figure RE-1. The decision path of Laya as reconstructed from the tensor inventory and the open-source runtime. Red: the two places where the studies in this series find problems (positional dependence through the encoder; the option-count temperature). Note on the unused parallel layout. uses_parallel_layout(cfg) reads option_layout from the config and defaults to sequential; the base config has no such key. The docstring in says a checkpoint trained on one layout reads the other “as a different input”, so switching layouts requires training, which is outside this paper. Provenance. Header-inspection evidence ev_2648a4101f7787d1303a… (base, full-file SHA-256 891102d372688fc2a094dac56a384bc537b87c63f21f9f3dac0be2b7cbc8d86c) and ev_fbf433f9d808bc103606… (Maya-v1, 632868e784f96b313cb48cefa996dd78a392d27b056cf2a69d6798deb9ddab7c). The tensor names, shapes and dtypes of the two files are different: all of our fixes change weight values and (for some) the JSON config, never the architecture. The inspection reports declared header facts only; it does not run the model, so everything behavioural below is measured black-box. 3.4 Hypotheses from the re-engineering H1 (position enters through the encoder). The head has no positional-embedding tensor (Table RE-1 lists none): its two layers are permutation-equivariant over slots, and the type embedding is the same for every slot. The only way an option’s position can influence its logit is through the encoder, whose rotary positions put each [MASK] marker at a different offset in the sequential layout. Prediction: answers change under reordering although the option texts are identical. H2 (the effect is largest for the first and last slot and for many options). Rotary attention makes the first marker adjacent to the instruction and the last adjacent to the state; both are privileged. Prediction: a U-shaped accuracy curve over the gold slot, strongest at K=12. H3 (shuffled fine-tuning is sufficient). If the dependence is learned rather than architectural, presenting options in random order during fine-tuning should remove it without touching the layout. Prediction: v1 flips far less than the noshuffle ablation trained on identical rows. 4 Data, protocol and statistics 4.1 Held-out data from an LLM teacher Figure M-0. Study design. Green boxes are the validity checks added after the first drafts: an independent LLM family re-labels every test item, and a classical baseline is trained on exactly the same rows. We cannot ship human-labelled test sets for these gaps, so we generate them. For each category a prompt asks Qwen3.8-27B (thinking disabled) for ten realistic inputs whose correct answer is a stated label, with category hints (for example, “each text must contain a negation”). A second, independent call is shown the same inputs without the intended label and asked to choose; any input on which the two calls disagree is discarded. Exact prompts are in Appendix A. The filter removes inputs that are ambiguous to the teacher, but it also removes hard-but-valid cases, and it cannot remove errors the teacher makes consistently. The test sets therefore measure agreement with Qwen, not human ground truth; we return to this in each paper’s threats section. Table M-1. Candidates written by Qwen3.8-27B, and how many survive the blind re-labelling pass (generator-vs-relabeller agreement). Category Generated Kept Agreement hw_failure 100 82 82.0% json_state 90 58 64.4% many_hr 773 716 92.6% many_options 240 195 81.2% mix_Arabizi 60 53 88.3% mix_Hinglish 60 58 96.7% mix_Spanglish 60 47 78.3% sentiment_clean 111 106 95.5% urgency 477 229 48.0% ml_* (12 languages) 1,420 1,289 90.8% Table M-2. Data splits (rows after de-duplication). Split Rows Use train 2,818 fine-tuning (all Maya variants) probe 224 first gap scan; reported before/after by laya-train Split Rows Use sent_test 106 held-out: sentiment, injection, long-context json_test 58 held-out: JSON tickets hw_test 82 held-out: hardware-validation failure class many_test 195 held-out: 12-topic question ml_test 322 held-out: 12 languages urg_test 78 held-out: urgency (score) ml_train / urg_train 967 / 151 extra rows used only by the multilingual / urgency variants 4.2 Training Every Maya model is Laya fine-tuned with its own trainer and loss (RLCD: a policy-gradient-style term over noisy logit samples rewarded by a proper scoring rule, plus soft cross-entropy), so the only experimental variables are the training rows and (where stated) the seed. Training takes minutes on one consumer GPU. Table M-3. Fine-tuning recipe (laya-train; identical for every variant unless stated). Setting Value epochs 4 micro_batch 8 grad_accum 8 encoder_lr 2.5e-05 head_lr 0.0001 min_lr 1e-06 weight_decay 0.01 grad_clip 1.0 loss rlcd rl_samples 4 sigma_start 0.4 sigma_end 0.1 w_sph 0.75 w_rps 1.0 option shuffling on for choice questions (off only in the no-shuffle ablation) calibration holdout carved from the training data by laya-train (fits temperatures; never the test sets) hardware / software 1× RTX 4090 (24 GB), torch 2.11.0+cu128, transformers 5.20.2, laya 0.4.26 seed 0 unless a seed is named 4.3 Statistics Proportions carry Wilson 95% intervals [Wilson 1927]. Two models on the same items are compared with the exact two-sided McNemar test [McNemar 1947]. Rates that are not per-item correctness (flip rate, ECE) use a row-level bootstrap with 1,000 resamples (300 where a statistic is expensive) [Efron and Tibshirani 1993]. We use α=0.01 and a minimum practical effect of 5 points, fixed before the fix results were computed (see no multiplicity correction is applied across the ten gaps we scanned, which is why we require both a small p-value and a non-trivial effect. ECE uses 10 equal-width bins unless stated. 4.4 Leakage audit Exact duplicates between test and training rows are removed during generation. To check for near-duplicates we computed, for every test item, the character-5-gram Jaccard similarity to its most similar training row. Median maximum similarity is 0.08–0.15 across sets, and 0.1% of items on average reach 0.5 (worst set: 0.5%). Accuracy on the low-similarity subset equals overall accuracy to within 0.0 points, so we find no sign that gains come from memorised neighbours. 4.5 Order-sensitivity protocol Questions are taken from every test set whose question type is choice with K≥3 (951 items; categories in Table 2). For K≤5 the options are rotated cyclically, giving K orderings in which every option appears in every slot once; for K=12 six random permutations are drawn once (seed 1) and reused for every item and every model, so all models see identical presentations. Flip rate is the fraction of items whose predicted option differs across orderings. Gold-slot accuracy averages correctness over all (item, ordering) pairs in which the gold option sits in a given slot. Vote accuracy counts an item as correct only if the gold option is the unique plurality answer over orderings. Flip rate has a non-zero floor on ambiguous items, so we always compare models on identical items and use the no-shuffle ablation as the matched control. 5 Results: how order-sensitive is Laya? 5.1 Headline Table 1. Order sensitivity over 951 choice questions (K≥3), and over the 605 English-language items only (the 12 native-language categories are excluded in the third column because the English root is close to guessing on them). Flip rate: answer changes under at least one reordering. Mean acc.: accuracy averaged over all orderings. Vote acc.: confidence-weighted vote over all orderings (costs K× compute). Model Flip rate, all [95% CI] Flip rate, English only Mean acc. Vote acc. Laya (root) 25.8% [22.9–28.7] 19.7% [16.5–22.8] 69.1% 69.7% Laya typed-decisions 12.5% [10.3–14.7] 12.9% [10.2–15.5] 71.0% 71.8% Laya-multilingual 19.2% [16.9–21.7] 26.0% [22.5–29.4] 67.4% 67.7% Maya-v1 w/o option shuffle 11.4% [9.5–13.6] 8.3% [6.1–10.6] 86.6% 87.2% Maya-v1 7.2% [5.7–8.9] 4.5% [3.0–6.1] 86.3% 86.2% Maya + parallel layout (authors’ architectural fix) 0.5% [0.1–1.1] 0.3% [0.0–0.8] 86.0% 85.9% Maya + name augmentation 8.2% [6.5–9.8] 6.0% [4.1–7.8] 86.8% 87.5% The root checkpoint flips on 25.8% [22.9–28.7] of all questions (gap criterion — lower bound >10%: met). The nativelanguage categories (36% of items) are much less stable (36.4% flip) because the English root is close to guessing on them; excluding them, the root flips on 19.7% [16.5–22.8] of 605 English items, so the gap holds on English text alone. The authors’ typed-decisions fine-tune flips on 12.5% (English only: 12.9%), and the shipped multilingual checkpoint on 19.2%, so the effect is not specific to one checkpoint. 5.2 By category and option count Table 2. Per category: option count K, items, flip rate (base / no-shuffle ablation / Maya-v1) and mean accuracy (base / Maya-v1). Category K n Flip base Flip no-shuffle Flip v1 Acc base Acc v1 hw_failure 5 115 33.0% 10.4% 4.3% 61.9% 96.9% injection 3 21 9.5% 4.8% 4.8% 88.9% 96.8% json_state 3 76 6.6% 1.3% 0.0% 66.7% 89.5% many_options 12 270 26.7% 9.6% 5.9% 72.8% 92.6% ml_Arabic 3 28 60.7% 21.4% 28.6% 38.1% 51.2% Category K n Flip base Flip no-shuffle Flip v1 Acc base Acc v1 ml_Bengali 3 26 84.6% 15.4% 19.2% 24.4% 37.2% ml_Chinese 3 29 20.7% 6.9% 10.3% 77.0% 95.4% ml_German 3 27 11.1% 0.0% 3.7% 85.2% 97.5% ml_Hindi 3 27 63.0% 25.9% 14.8% 38.3% 55.6% ml_Japanese 3 30 26.7% 0.0% 3.3% 76.7% 98.9% ml_Korean 3 21 38.1% 33.3% 23.8% 52.4% 60.3% ml_Portuguese 3 22 0.0% 9.1% 0.0% 81.8% 86.4% ml_Russian 3 28 32.1% 0.0% 3.6% 67.9% 95.2% ml_Spanish 3 28 0.0% 14.3% 14.3% 71.4% 81.0% ml_Tamil 3 28 89.3% 64.3% 10.7% 35.7% 39.3% ml_Turkish 3 28 17.9% 10.7% 7.1% 66.7% 86.9% multilingual 3 24 25.0% 20.8% 16.7% 52.8% 65.3% negation 3 17 0.0% 17.6% 11.8% 88.2% 88.2% sentiment_clean 3 106 1.9% 6.6% 2.8% 94.0% 95.6% Order sensitivity is far from uniform. The most unstable base categories are ml_Tamil (89%, n=28), ml_Bengali (85%, n=26), ml_Hindi (63%, n=27); the most stable are ml_Portuguese (0%, n=22), ml_Spanish (0%, n=28), negation (0%, n=17). Instability tracks difficulty: categories on which the base model is inaccurate are the ones that flip. Because the sets differ in difficulty, flip rate and accuracy are confounded, which is why every comparison in the fix section is made on identical items. 5.3 Where the gold option sits Figure 1. Accuracy as a function of the slot the gold option occupies, for the three option counts in the test pool. Averaged over all items the base model is 77.1% accurate when the gold option is first and 67.0% when it is last (difference 10.1%). For K=12 the accuracy over the twelve gold slots ranges from 67% to 77% for the base model, 90% to 94% for fine-tuning without shuffling, and 91% to 94% with shuffling (Figure 1; with six permutations per item each slot has far fewer observations than at K=3, so individual points are noisy). First-vs-last accuracy without shuffling is 88.6% / 85.7% and with shuffling 85.3% / 86.9%. 5.4 Where the predictions land Figure 2. Distribution of the slot chosen by the model. Because every option appears in every slot equally often (rotations), an orderblind model would follow the dashed line apart from genuine errors. Under rotations every option occupies every slot equally often, so the share of predictions per slot should be near 1/K for an order-blind model that is mostly right. The total-variation distance from uniform is 0.092 (K=3) and 0.069 (K=12) for the base model, 0.024 / 0.048 without shuffling and 0.002 / 0.049 with it. 5.5 Is the instability visible in the model’s own confidence? Table 3. Flip rate by tercile of the mean confidence the model reports across the orderings of that question (terciles fixed on the base model). Model Lowest confidence Middle Highest Laya (root) 53.9% (n=317) 15.8% (n=317) 7.6% (n=317) Maya-v1 73.7% (n=19) 28.7% (n=171) 0.7% (n=761) Largely yes. For the base model the flip rate falls from 54% in the least-confident tercile to 16% and 8%; among the 20% of questions on which it is most confident, 2.6% still flip. Confidence is therefore a useful, imperfect detector: a caller that abstains or re-queries with a shuffled order when confidence is low removes most unstable items, but 8% of even the most confident tercile can change answer under reordering. For Maya-v1 the corresponding figures are 74% / 29% / 1%, with most items in the top tercile. 5.6 A no-training alternative: voting over orderings Because Laya exposes option_order, a caller can average over reorderings at inference time. Taking a confidenceweighted vote over all 4.1 orderings (on average) moves the base model ..."
Posted a Laya demo on X? Mention “Laya” and it gets picked up automatically, or submit the project.


