Seen on X

What people are building with Laya.

Demos, games, ports and benchmarks posted on X, picked by hand. Each one links back to the original post and, where there is one, to the project in the directory.

jev-touhou uses Laya and Mica to play an open-source Touhou game

this is a f*cking treasure for JEV devs and I'm not kidding Jevs founder Diogo Almeida just mentioned his favorite github repos people are putting small decision models inside coding agents, QA systems, desktop control, smart homes, YouTube filters and real-time games these 10 make the architecture click: JevAny - open infrastructure for training, evaluating and deploying your own System One decision models ↳ jev-stars - turns your GitHub stars into searchable memory for coding agents, with cached Jev tagging and a built-in MCP server ↳ agentic-sop - runs an entire software-development lifecycle around coding agents, then uses Jev as a quality gate before human approval ↳ jevqa - tests web apps from plain-English checklists; Playwright controls the browser while Jev chooses elements and judges each step ↳ ha-gutcheck - performs weekly Home Assistant health checks and uses Jev to classify broken integrations, risky updates and missing device metadata ↳ claude-jev - a Claude Code plugin that sends prompt routing, rule checks and context compaction to Jev instead of a frontier model ↳ harness-router - places Jev directly inside the tool-selection loop for Codex and Claude Code, with confidence fallback and optional MCTS ↳ jev-touhou - a local Jev-pattern engine using Laya and Mica to play an open-source Touhou game one decision at a time ↳ FeedKeeper - a Chrome extension that asks Jev whether each YouTube recommendation belongs to a category you want removed ↳ jev-bot - lets Codex and ChatGPT control native macOS applications while Jev selects the right control from the accessibility tree ↳ pick by what you are building: > coding agents → claude-jev, agentic-sop > tool routing → harness-router > testing → jevqa > local decision models → JevAny, jev-touhou > personal infrastructure → jev-stars, FeedKeeper > smart homes → ha-gutcheck > computer use → jev-bot the interesting part is not that all ten “use AI.” each project gives the model a closed set of answers, asks for one narrow judgment and leaves execution, permissions and state inside ordinary code that is the Jev pattern find one expensive decision your agent repeats hundreds of times and replace it before your next frontier-model bill arrives

♥ 30↻ 42.4k viewsView on X
Project: JevAny→

Jev, Laya and CLM-8B compete in no-search chess matches

Open source just beat Jev at chess ♟️ I made decision models (Jev, Laya, CLM-8B) play chess against each other, and the results blew my mind 🤯 The rule: no search. One look at the board, pick a move. Zero-shot, Jev won 29/30 vs untrained models. But after just ~10 minutes of fine-tuning, CLM-8B beat Jev: 4W 5D 1L. Full breakdown + every game replay in the blog post 👇

♥ 30↻ 01.1k viewsView on X

Acurast runs Laya Snake demos on an Android phone

最近 AI Agent 炒得这么热,我反倒开始好奇一个问题:以后 AI 真要满世界替人干活,算力从哪里来? 总不能所有任务都挤在几个大厂的数据中心里吧? 刚好最近 @Acurast 有几个动作,我觉得可以放在一起聊聊。 9 月 28 日,Acurast 展示了 Laya 这类轻量级 AI 决策模型在手机网络上的运行能力。10 月 2 日又放出了 9 个在线演示,其中包括贪吃蛇游戏,背后做决策的模型实际运行在 Acurast 网络的一部 Android 手机上。 这个我还真挺感兴趣的。 以前看到手机挖矿、手机算力,我第一反应就是:又来一个让人挂机赚币的项目? 但这次有点不一样。 Acurast 已经有超过 31.8 万部手机接入,覆盖 175 多个国家。现在开始展示具体的 AI 运行场景,至少让大家能看到这些手机到底可以拿来干什么。 当然,能跑一个轻量模型,距离真正抢到云计算市场的生意,还有很长一段路。 但我觉得它选的方向挺有意思。 现在大家天天研究 AI Agent、研究哪个项目又融资了几千万美元,真正愿意去看底层算力怎么分配的人反而没那么多。 如果未来大量 AI Agent 只需要处理分类、判断、简单执行这些小任务,未必每次都需要昂贵的 GPU。 这可能就是 Acurast 想切进去的市场。 而且最近 Acurast × XHunt 的创作者活动也开始了,9 月 30 日到 10 月 25 日,前 150 名分享 20 万枚 ACU。 我觉得这轮活动有个细节值得注意,40% 的 Impact Share 跟有效邀请挂钩。 项目方明显希望创作者带来的不只是浏览量,还要有人真的进入生态。 我最近也准备好好研究一下它的手机节点,看看闲置手机到底能创造多少价值。 不过话说回来,我现在最想知道的还是:这几十万部手机里,有多少算力已经被真正付费使用? 如果以后这部分数据也能跑出来,Acurast 才更有东西可聊。 @EchoHunt_ai

♥ 29↻ 01.8k viewsView on X

Laya makes real-time Doom decisions on a phone through Acurast

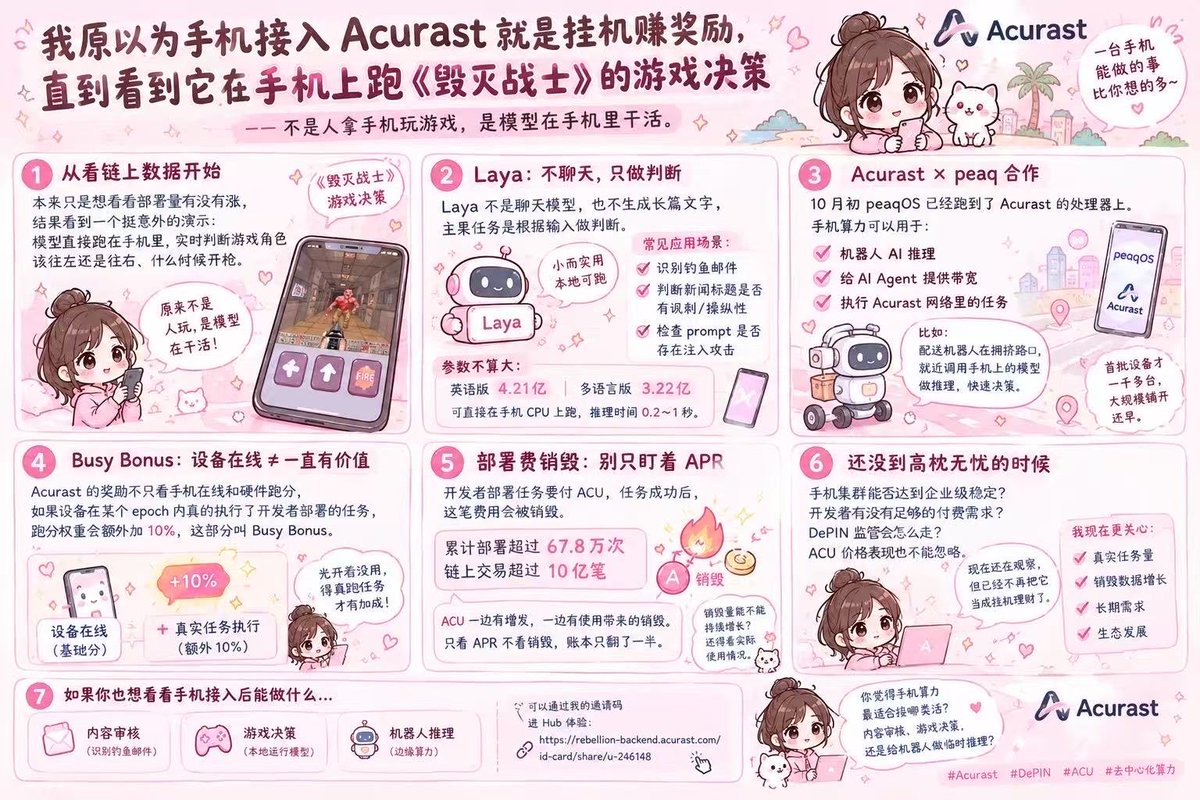
我原以为手机接入 Acurast 就是挂机赚奖励,直到看到它在手机上跑《毁灭战士》的游戏决策 前段时间翻 Acurast 的链上数据,本来只是想看看部署量有没有涨,结果看到一个挺意外的演示:模型直接跑在手机里,实时判断游戏角色该往左还是往右、什么时候开枪。 不是人拿手机玩游戏,是模型在手机里干活。 我盯着演示看了一会儿。之前写接入教程,我一直觉得 Acurast 主要就是跑 API、定时任务这些东西。后来顺着官方文档和社区讨论继续看,才发现它能接的活比我想象中杂。 先说 Laya,这个模型有点意思。 我最早在 9 月底的公告里看到这个名字,当时没太在意,以为又是一个普通的 AI 模型。后来才发现,它不负责聊天,也不生成长篇文字,主要任务是根据输入做判断。 比如识别一封邮件是不是钓鱼邮件,判断新闻标题有没有讽刺或操纵性,或者检查一段 prompt 是否存在注入攻击。 参数不算大:英语版 4.21 亿,多语言版 3.22 亿,可以直接在手机 CPU 上跑,推理时间大概 0.2~1 秒。 这让我想到,手机端 AI 未必非得什么都能做。识别一条钓鱼短信、给新闻分类、帮游戏角色选下一步,很多任务不需要一个庞大的模型。能在本地快速跑、不依赖云端,也不用把敏感数据传出去,反而更实用。 再说 Acurast 和 peaq 的合作。 10 月初,peaqOS 已经跑到了 Acurast 的处理器上。按照官方介绍,手机算力除了执行 Acurast 网络里的任务,也可以用于机器人 AI 推理、给 AI Agent 提供带宽这些场景。 举个例子,一台配送机器人走到拥挤路口,需要快速判断怎么走,就近调用一台手机上的模型做推理,拿到结果再做决策。 这个方向我能理解。机器人如果每次判断都依赖远端服务器,网络延迟和连接稳定性就会成为问题。但手机算力够不够机器人用,我现在判断不了。首批接入 peaqOS 的设备也就一千多台,大规模铺开还早。 真正让我多看了几遍的,是 Staked Compute 里的 Busy Bonus。 Acurast 的奖励不只看手机在线和硬件跑分。如果设备在某个 epoch 内真的执行了开发者部署的任务,跑分权重还会额外加 10%,这部分叫 Busy Bonus。 手机一直开着,不等于它一直在创造价值。真接到任务、提供算力,才能多拿。 这个设计把两件事分开了:设备在线是一回事,网络有没有实际使用它,是另一回事。DePIN 网络很容易出现设备数量看着漂亮、实际需求说不清楚的问题。相比单纯统计在线设备,真实任务执行情况更能反映有没有人在用。 当然,Busy Bonus 只是一个激励。付费需求能不能持续,我还在看。 另外,我最近也开始关注 ACU 的部署费销毁。 开发者部署任务要付 ACU,任务成功执行后,这笔费用会被销毁。我看到的数字是,累计部署超过 67.8 万次,链上交易超过 10 亿笔。这两个数字不是一回事,不能直接画等号。 我比较关心的是,部署费销毁能不能持续增长。ACU 一边有增发,一边有使用带来的销毁。只看质押 APR 不看销毁,账本只翻了一半。 但也别急着把销毁和币价上涨画等号。销毁量增加,说明使用行为在增加;它能不能抵消增发、能不能改善供需,还得看具体数量和持续性。对我来说,这比只看 APR 有参考价值。 Acurast 也没到可以高枕无忧的时候。手机集群能不能达到企业级稳定,开发者有没有足够的付费需求,DePIN 监管会怎么走,这些都需要时间验证。ACU 的价格表现也不能忽略,网络增长不一定直接反映到币价上。 研究完这一圈,我最大的变化是:以前看到手机接入去中心化算力网络,首先想到的是挂机和奖励;现在才开始认真想,这些手机究竟能接到什么任务,又有多少任务是真的有人愿意付钱。 一台闲置手机,帮邮件识别一次风险,替游戏角色做一次判断,或者给机器人提供一次推理服务。这些事情单独看都不大,但如果有足够多的真实需求,才有可能撑起一个算力网络。 至于 Acurast 最后能不能跑出来,我还想继续观察。 如果你也想看看手机接入后能做什么,可以通过我的邀请码进 Hub: 你觉得手机算力最适合接哪类活?内容审核、游戏决策,还是给机器人做临时推理? @Acurast #Acurast #DePIN #ACU #去中心化算力

♥ 29↻ 01.9k viewsView on X

Laya AI demo runs decision tasks on Acurast Android phones

@Acurast × @EchoHunt_ai 活動已經進入最後一週,還沒衝的兄弟們,這幾天真的要把握機會了! 這次 EchoHunt 的獎勵池有 20 萬 ACU,活動排名由內容表現和有效邀請共同決定,分別佔 60% 與 40%。 這也代表,光靠持續發文還不一定夠。如果有效邀請的成績跟不上,即使內容寫得不錯,最終排名還是可能被其他人逐漸拉開。 所以最後一週,我覺得可以把握兩個方向:一邊繼續產出有品質的內容,一邊檢查自己的邀請進度,看看還有哪些地方能補強。與其一直盯著排名下滑,不如趁活動結束前,把還能做的事情做好。 畢竟活動都走到最後階段了,現在放棄真的有點可惜。就算目前的排名不如預期,只要活動還沒結束,就還有繼續努力的空間。 而且最近 @Acurast 本身也有不少值得關注的進展。 目前網路已連接超過 33.5 萬台手機,覆蓋 175 個以上的國家,累積超過 10 億筆鏈上交易與 68 萬次部署。這些數據讓我更想了解,閒置手機參與去中心化運算,究竟能在 AI 時代發揮多大的作用。 近期推出的 Laya AI Demo 也很有意思,透過 Acurast 網路上的真實 Android 手機執行 AI 決策任務,不需要依賴傳統大型資料中心。雖然目前展示的還是一些簡單應用,但至少能讓大家直接體驗這種運算模式,而不只是看官方介紹。 另外, base:0xc5fed7c8ccc75d8a72b601a66dffd7a489073f0b 最近也登陸 Bithumb 韓元市場,後續的市場表現同樣值得觀察。 不過,這些進展可以慢慢研究,眼下最直接的機會還是 EchoHunt。 最後一週,把內容做好、邀請補起來,別因為一時排名不理想就提前離場。

♥ 28↻ 13.5k viewsView on X

Laya runs decision demos on Acurast phones, from moderation to games

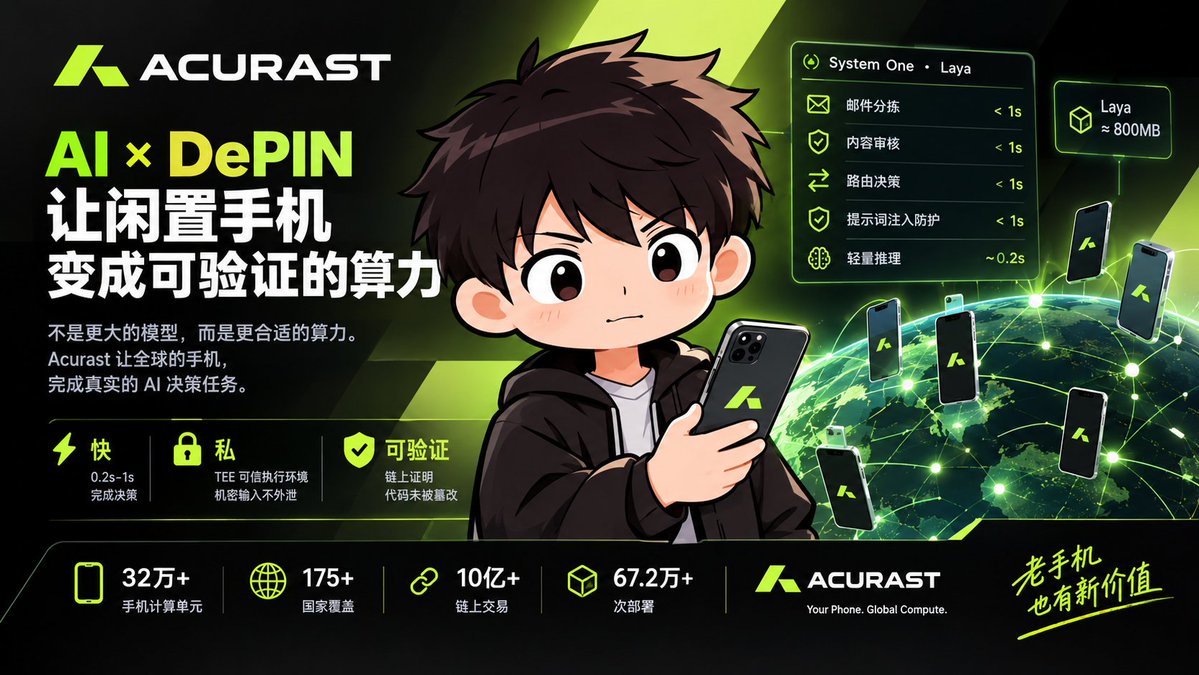
我一开始看 AI × DePIN,也会先问:手机能不能凑出一张像样的 GPU。 后来我发现,这个问题对我没什么用。我遇到的调用,大多不是写长文,是在固定选项里做一次判断。垃圾邮件进不进收件箱,提示词注入拦不拦,内容放不放行,路由走哪条。它们没什么上下文,输入却常是公司最敏感的文本。我要的是快、私、可验证,不是 H100。 我关心的不是训练,是决策 Acurast 把这类模型叫 System One:小、无状态、一次请求一次结论。 Laya 大约 800MB,跑在手机 CPU 上,短问题约 0.2 秒给出结果,整理一封邮件通常不到 1 秒。它比数据中心 GPU 慢,但对审核、路由、代理前置过滤来说,够用。 前沿模型继续堆在 GPU 集群里,这一点短期不会变。但判断开始外溢。我看的不是手机要当数据中心,是算力错配。 我把旧手机当成已经分发的供给 全球每年大约卖出 13.9 亿部智能手机,换机周期不到三年。换下来的机器,处理器往往还好,只是进了抽屉。 云厂商要花几亿美元建一个区域。手机网络不用建,因为设备已经散落在用户所在的国家。 Acurast 官方文档写的是约 30 万个计算单元,覆盖 175 个以上国家。项目 X 账号近期标注为 32 万部以上手机、超过 10 亿笔链上交易、67.2 万次以上部署,支持 Android、iOS 和 Solana Mobile。 数字会随接入浮动。方向很清楚:供给是已经造好、已经分发的消费级硬件,不是待采购的服务器。 我最在意执行证明 Acurast 把手机变成无服务器计算节点。开发者通过 CLI、SDK 或 Hub 部署 REST API、webhook、定时任务、LLM 推理或机密计算。手机上的 Processor 应用大约三分钟完成接入,并在链上报告基准和心跳。 关键不是“谁的手机在线”,是执行证明。 任务跑在手机自带的可信执行环境里。代码在硬件隔离区执行,设备主人看不到机密输入。完成后给出密码学证明:代码没被篡改,硬件是厂商认证的真机。协调层用 Substrate 链做匹配和声誉,执行层是手机上的安全硬件运行时。 2026 年推进的 Cargo 容器,让开发者可以把接近云上的负载打包后丢到这张手机网络上,不用为每个任务重写一套节点逻辑。 很多 DePIN 只协调存储、带宽或机房 GPU,不证明“跑的就是你提交的那段代码”。Acurast 把验证压进消费级安全芯片,所以机密推理不用先信任节点运营者。 我看已经跑起来的任务 Canary 网络从 2023 年 7 月起步。2026 年 1 月 20 日,Acurast 宣布主网与 TGE 上线,网络从激励测试网切到可开放权限的生产层。 此前公开数据包括约 16.9 万部手机、36 万次以上部署、5.89 亿笔以上链上交易。主网后规模继续上行。2026 年 2 月,项目把约 22.5 万到 22.7 万部手机的计算网络接到 Base,用于链上机密 AI 推理。 更能说明算力被用起来的,是 2026 年 9 月底到 10 月初的 Laya 部署。邮件分拣、聊天审核、标题党识别、提示词注入防护,甚至贪吃蛇和俄罗斯方块的决策,都由同一类 System One 模型在真实手机上完成。演示页会标出执行手机所在国家、芯片和已处理次数,并可在链上核对。官方举例里,这类部署的日成本可以压到 1 枚 ACU 以下。 它还不是通用大模型的替代品。但它已经是可付费、可验证、跑在别人手机上的生产形态任务。 我看 ACU,只看结算 ACU 初始供应 10 亿枚,用于支付计算、奖励算力提供者、质押和治理。公开设计里,年通胀固定为 5%,其中 70% 进入质押计算池,10% 进入计算池,15% 进入链上金库,5% 给 collators;早期支持者分配被压在约 6.5%。 计算费用侧还有销毁设计。没有手机的人也可以把质押委托给节点,分担相应风险。节点靠在线时长和完成任务获得奖励。 如果付费任务继续从奖励分发转向真实结算,ACU 的使用就会从“接入激励”延伸到“决策调用的计价单位”。市值会波动。我更看网络有没有继续接到付费工作负载。 我最近在跟的活动 @EchoHunt_ai 与 @Acurast 的创作者活动,从 2026 年 9 月 30 日持续到 10 月 25 日(UTC+8),奖池 20 万枚 ACU,按 Impact Share 分给前 150 名合规创作者。 内容表现约占 60%,通过个人 Acurast 邀请码带来的有效邀请约占 40%。每人每自然周最多计入两篇原创,同期同步到币安广场还有加成。官方主题正好落在 ACU 的使用与质押、AI × DePIN 如何释放手机算力,以及闲置手机如何变成可验证节点。报名需绑定本人 X 账号,并与 Acurast 身份卡一致。 我不指望抽屉里的旧手机取代训练集群。 它们更可能承接的,是那些必须快、必须私、又不能把原文交进别人机房的决策。Acurast 已经把主网、三十万量级手机和真实的 Laya 调用接到了一起。 快来加入我们吧:

♥ 27↻ 06.9k viewsView on X

Laya demos run email sorting and moderation on Android phones

手机适合承担哪些任务,要从实际需求出发。分类、筛选、简单决策,就是值得尝试的方向。 AI 应用每天反复要做的工作,一封邮件该进收件箱,还是垃圾箱?一句聊天内容需不需要拦截? 这就是 @Acurast 为什么研究手机算力的原因。 Acurast 在 10 月 2 日介绍的 Laya 演示,给出了一个可以直接体验的例子: 9 个在线 Demo,背后的模型运行在 Acurast 网络的 Android 手机上。 其中有邮件分类、聊天内容审核,也有判断提示词是否存在攻击意图的演示。请求发给手机,模型根据问题和给定选项返回判断。 官方介绍的单次响应约为 0.2—1 秒,具体表现会受到设备和任务影响。 这件事吸引我的地方,是手机算力终于对应到了一个清楚的用途:给应用提供可以调用的判断服务。 当然,模型会犯错。官方披露的一次邮件分类测试中,160 封邮件判断对了 144 封,约 90%。这组结果也提醒我们,它更适合承担第一轮筛选,重要判断仍需要后续核验。 我反而觉得,把能力和边界一起讲清楚,更方便开发者判断要不要用。 再看供给端,同一篇官方文章提到,Acurast 网络已有 32 万部以上手机。设备规模说明它已经聚集了一批计算资源;能否让这些资源持续服务应用,还要看部署体验、运行质量和真实需求。 这时候, $ACU 在网络里的作用就值得放在一起看了。 开发者与网络交互,需要支付费用;提供计算资源的参与者,可以按协议规则获得激励。Staked Compute 则把算力贡献与质押结合起来,持币者也可以通过委托参与,或通过治理投票影响协议发展。 开发者、设备提供者和代币持有者,因此有了各自参与网络的方式。 我理解的 AI × DePIN 机会,就藏在这些具体连接里: 应用需要一次判断,网络找到能执行的手机,设备完成计算,协议记录使用并提供相应激励。 如果这样的服务足够好用,开发者愿意反复调用,手机资源就有机会形成持续需求,$ACU 的实际用途也会随之得到检验。 对普通用户来说,这条路径也很有意思。手边符合要求的闲置手机,有机会成为计算资源的提供者,参与门槛落到了自己能够接触的硬件上。 所以,了解 Acurast 可以先从一个小动作开始:打开 Laya 的演示,写一封邮件,或者输入一条待审核的消息,看看远处那台手机会怎么判断。 当一次 AI 请求真的由手机完成,手机算力的价值就有了可以体验的形状。 $ACU #Acurast #DePIN #AI @EchoHunt_ai

♥ 27↻ 18.7k viewsView on X

Laya routes messages and classifies email on Acurast phones

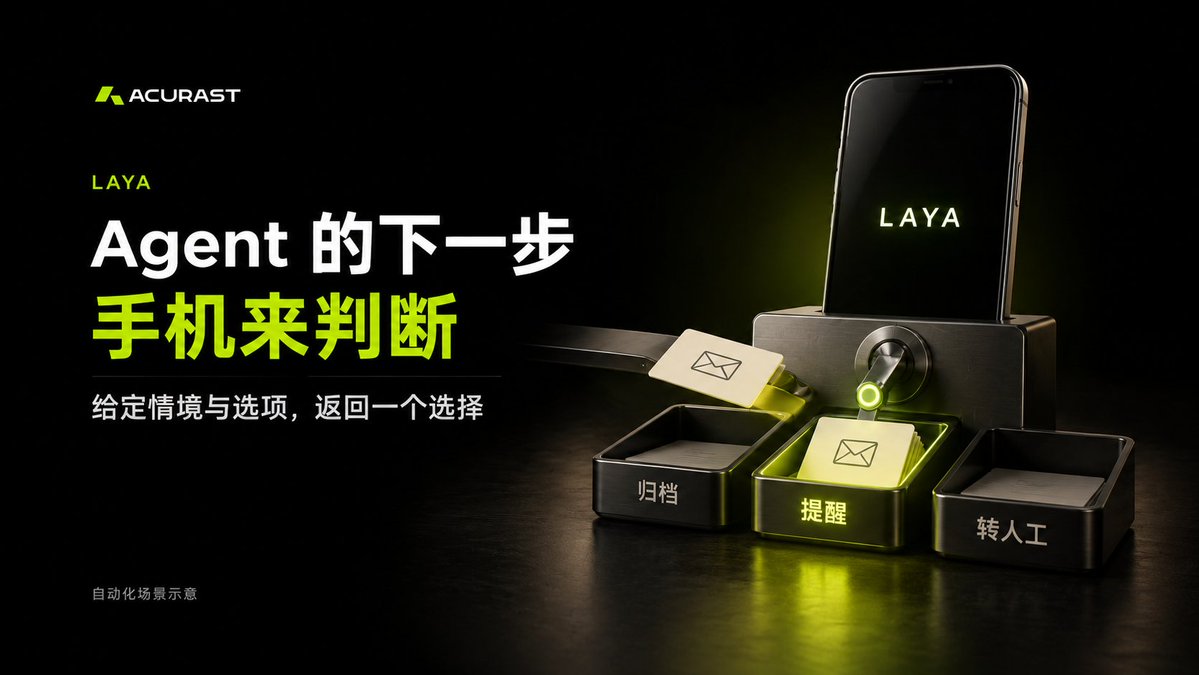
Acurast 给手机找了个活:替 Agent 决定下一步 一封邮件该归档还是提醒?一条消息该放行还是转人工? 这些环节只需要一个判断。每次都让 AI 写一大段,程序还得从里面找答案,多少有点绕。 @Acurast 10 月 20 日介绍的 Laya,就是把当前情况和几个选项交给模型,由网络里的手机完成推理,返回选择和对应概率。官方演示给出的响应时间约为 0.2—1 秒,取决于设备和任务。 放到自动化里,用途就清楚了。 比如消息进来,先分到不同队列;普通通知归档,需要分析的内容再交给后面的模型。每个环节拿到明确结果,程序就能继续往下走。 这种分工,我愿意多研究。一个工作流里,写内容、做判断、执行操作,本来就可以交给不同工具。手机能接住其中一段,就有了实际用途。 当然,选项少也会选错。官方披露的邮件分类测试是 160 封判对 144 封;聊天消息来得太快,处理队列也会积压。接自己的业务,还是得拿真实样本测,尤其要看看错分的那部分会造成什么麻烦。 这次可以直接出题,不用只看演示视频。给它一封难分类的邮件,或者改一下游戏策略,看看那台手机会怎么选。 演示入口: 了解 Acurast,我的推荐入口👇 #Acurast #AI #DePIN

♥ 27↻ 013.2k viewsView on X

Acurast demonstrates local Laya decisions for Snake, email sorting, and suspicious-content detection

33万部旧手机凑在一起能干嘛 给我们家门口收废品的大爷最多10块一个全回收了 ♻️ 但 @Acurast 给除了不一样的答案 —— 替别人干活 家里淘汰的手机除了吃灰,还能把CPU、内存、安全芯片租出去 开发者付钱用算力,手机主人拿代币奖励。 以前共享经济共享的是房子和车,现在共享的是手机 先说规模,官方口径:主网今年1月上线,现在累计接入32.5万部手机,跑过67.8万次任务,覆盖175个国家。 我看到32.5万这个数字愣了一下 —— 传统云计算得建数据中心、买服务器、拉电,它直接借用全球已经存在的手机。 整个流程是这样的:开发者把程序丢进网络,系统匹配符合条件的手机执行,跑完把结果传回来,节点拿奖励。 安全这块靠手机硬件里本来就有的安全运算区(TEE),可以理解成手机里的保险柜,敏感计算在柜子里进行,钥匙在设备自己手里,外人摸不到数据。 我自己最关注的是AI这块。它10月发了个叫Laya的演示 让手机本地跑轻量模型——玩贪吃蛇、分类邮件、识别可疑内容,简单决策0.2到1秒出结果。 还出了教程教你在手机节点上跑OpenClaw。 这跟训练ChatGPT完全是两码事,手机那点性能只够干轻活。 但换个角度想,以后AI Agent真要满地跑,总得有地方接这种又小又散的任务。 收入来源我查到一个实锤:今年1月跟Massive合作,给它提供分布式带宽和住宅IP,用来做网页采集和市场监控。 代币ACU的逻辑倒是不绕:开发者用算力付的费用拿去销毁,节点奖励来自协议增发,初始10亿枚,每年通胀 5% 所以节点数涨多快不重要,销毁量才重要——真实需求进来多少,销毁才有多少。 现在我盯三个数:每天真正在线的设备有多少、每天有多少付费任务在跑、销毁能不能跑赢通胀。 33万台手机已经把供给端搭好了,需求端这门生意能不能赚钱,才是生死题。 先放观察列表,继续跟踪。 如果感兴趣可以点击链接🔗 让你的手机开启不一样的旅程哦~

♥ 26↻ 01.5k viewsView on X

Laya demonstrates built-in outbound rejection for chatbot queries

Conformal: The line is learned from the held-out set Abstain: If nothing clears the line, send it to a human/LLM, etc. Outbound: It's far away from the valley Imagine outbound as a user asking your business chatbot, "What is transformers?" and you reject it immediately, all without a system prompt guarding it! The new Laya is the first-ever decision model that has outbound integrated within the model

♥ 26↻ 2874 viewsView on X

Nine Laya demos and APIs run on phone CPUs with verifiable execution

最近天气开始降温了 , 不过现在这气温还挺舒服的不那么热,刚从外面回来发现 Laya 这次有个细节我挺在意:按 @Acurast 官方说明,部署一个 Laya 实例,每天不到1枚 $ACU。 这就有意思了。邮件分个类、审核一条消息、判断提示词有没有问题,单看都不是什么大任务。但一个应用每天反复做,计算开销就会慢慢堆起来。手机能接住这些活,开发者就多了一种选择。 现在有9个 Demo 和 API 可以试。模型在手机 CPU 上跑,应用把内容和选项发过去,收到判断再继续处理。具体哪台设备执行的,也能在页面查看,并核对链上记录。 我觉得接下来可以聊得更具体:同样一批任务,处理多久、错多少、花多少钱。部署便宜只是第一步,真正接入,还得测并发和稳定性。 $ACU 用于支付计算费用,成功执行后的费用会销毁,节点奖励则来自通胀。所以我会把实际使用和新增供给放在一起看。小任务如果能变成持续需求,手机算力就能从演示走进开发者的日常账单。

♥ 25↻ 13.6k viewsView on X

Acurast runs an interactive jailbreak guard demo on Android

Acurast 给 AI 加了个“门卫”,你可以试着骗过它 假设你让 Agent 整理邮件,某封邮件里却夹着一段要求它改任务的指令。 它要是把邮件正文当成命令,后面的自动化就可能跑偏。 @Acurast 的 Laya 演示里,有个 Jailbreak the Guard,专门把这件事做成了一个能互动的场景。你提交输入,模型判断该放行还是拦截,以及它像哪种攻击。负责判断的 Laya,运行在 Acurast 网络的一台安卓手机上。 我觉得这个用途很具体。 一个接收外部消息的助手,可以在入口处加一轮检查,把可疑内容先标出来。尤其是后面还要调用工具、处理业务数据的工作流,这一步值得单独做好。 官方给出的接口也比较直接。提交当前情境和候选选项,返回选择及相应概率,并提供 JavaScript、Python 等调用示例,方便开发者接入自己的应用。 当然,这个演示展示的是判断结果,门后没有真实助手。官方也明确说了,复杂的对抗性文本仍可能骗过模型。 所以我会把它当作初筛,涉及重要操作的权限另行控制。 这种演示好在,你可以自己出题,看看它哪里判断得准、哪里会漏。手机算力能做什么,也就有了一个具体的体验入口。 官方演示: 我的推荐入口👇 #Acurast #AI #DePIN

♥ 25↻ 05k viewsView on X

Jailbreak the Guard screens prompts with Laya on Acurast Android devices

Everyone is of the opinion that AI agents can be useful, but personally I think a problem most people overlook is the fact that one malicious instruction can turn them into a security risk. An email, document, or webpage could hide commands that manipulate an Agent into doing something it shouldn't. That’s the problem @Acurast is tackling with Jailbreak the Guard. Here’s how it works: → Submit a prompt → Laya approves or blocks it → The model classifies the potential attack → The decision runs on Android devices across Acurast’s decentralized network It’s not a perfect defense, but adding a security checkpoint before an Agent accesses tools or sensitive data makes sense. Now the bigger question: will developers put it to work at scale, creating real demand for $ACU? Time will tell, I guess.

♥ 25↻ 5362 viewsView on X

laya-mlx plays Snake at 60 decisions per second on an M3 Max

Introducing a version 50 times faster than Jev, running on your device: laya-mlx! Occupies a maximum of 1G memory only on your device Laya is an open-source classification system similar to Jev, based on text output probabilities I ported it to MLX and made some performance optimizations! In the video, this model is playing Snake on my local M3 Max This model can play Snake at a decision speed of 60 times per second!

♥ 24↻ 1914 viewsView on X

Laya classifies emails on Acurast phones in under a second

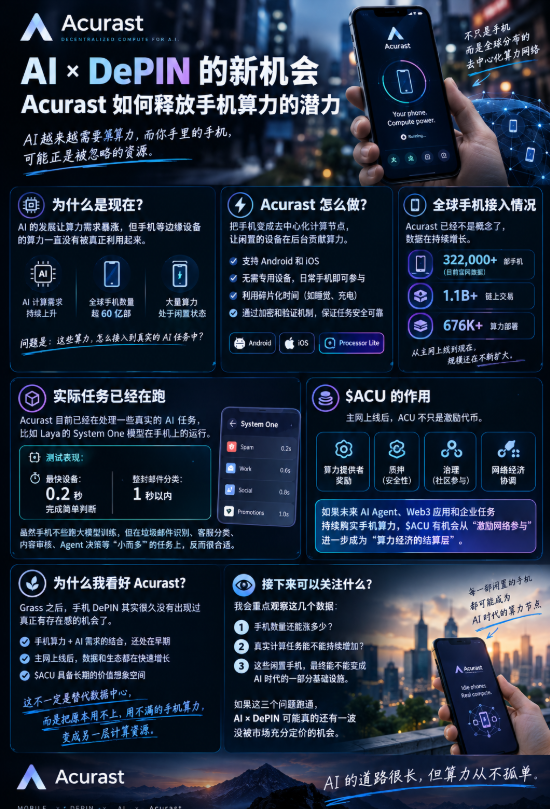
啥情况啊?@Acurast这是越写排名越靠后?幸亏参与的人不多,要不然又是妥妥的反撸啊。 今天继续深究AI与DePIN 这条线。 当下AI面临的最大挑战是什么?就是算力。 而算力提供者除了高端芯片外,往往还忽视了另一个提供者:手机。 Acurast当下就是要把被忽视的手机算力当成基础设施来建设。 今年1月份主网上线的时候,Acurast就已经接入超过16.9万部手机,完成36.4万多次部署和5.89亿笔链上交易。 截止到现在,官方首页的数据披露: 超过322,000 部手机 1.1B笔链上交易 676K的算力部署 尤为重要的是,这还不是尽头,它的规模还在继续往上走,并且现在已经开始跑真实任务了。 比如最近的 Laya,它把一个大约800MB的 System One 模型放进手机里运行。 令人惊喜的是效果喜人,用最快的设备处理简单判断任务只需要0.2秒,整封邮件的分类也可以在1秒以内完成。 虽然当下不能拿手机算力去硬刚训练GPT这种巨型模型。 但在垃圾邮件识别、客服分类、内容审核、Agent决策这些“小而多”的任务时,就非常适合这种分布式架构。 这就是我觉得 Acurast 有意思的地方: $ACU 在这个生态中也不仅仅是一个“DePIN代币”。 主网上线之后,#ACU 承担的是算力提供者的奖励、质押、治理以及网络经济协调这些角色。 在未来真的有越来越多 AI Agent、Web3 应用和企业任务跑进来,需求端开始持续购买手机算力的事后,那么 $ACU 就有机会从“激励网络参与”进一步变成“算力经济的结算层”。 手机数量还能涨多少?真实计算任务能不能持续增加?以及这些闲置手机,最终能不能变成 AI 时代的一部分基础设施。 当这三个问题跑通的时候,AI和 DePIN 可能真的还有一波没被市场充分定价的机会。 $ACU #Acurast #DePIN #AI

♥ 24↻ 18.9k viewsView on X

Laya demos email classification and chat moderation on phones

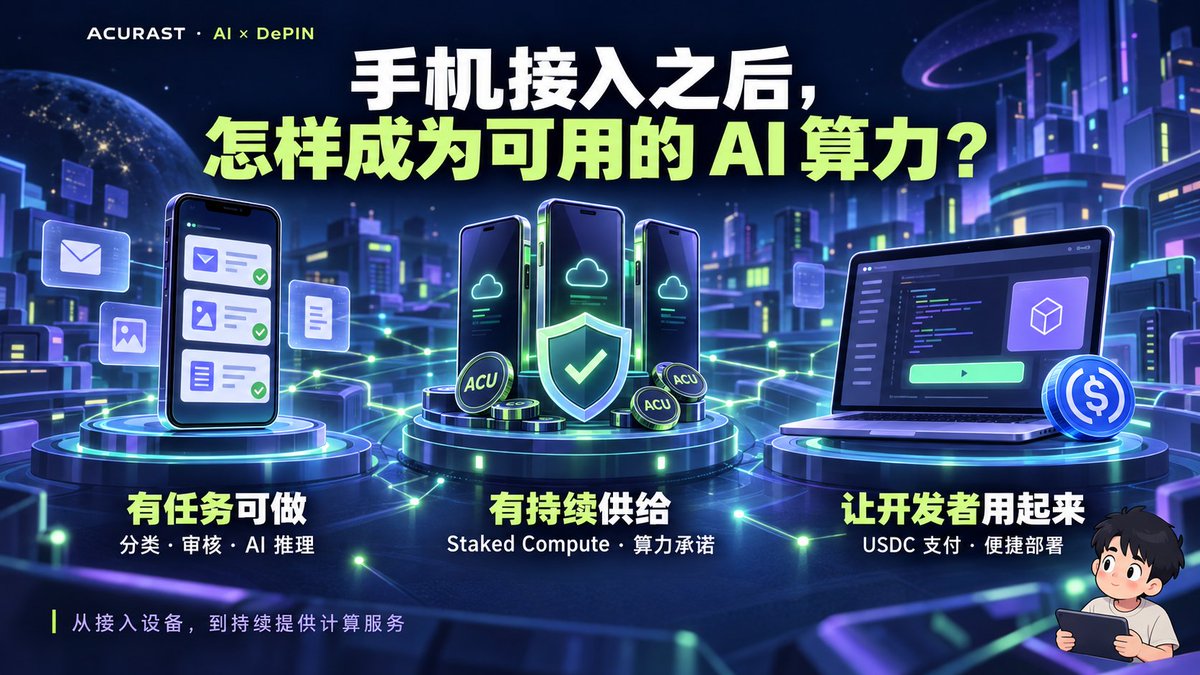
如果把一个每天都要运行的程序交给陌生人的手机,我最先问的应该是:设备靠谱吗?明天还在线吗?出了问题怎么办? 这是我最近看 @Acurast 时,越来越关心的事情。手机能跑 AI 已经有演示,接下来要解决的,是怎么把这些设备组织成可以持续使用的计算服务。 Acurast 通过 Processor 将手机接入网络,为开发者提供运行程序的资源。按照官方 10 月 14 日披露的数据,网络累计接入超过 33.5 万部手机,算力提供者分布在 175 多个国家,Genesis 主网也已在今年第一季度上线。 从这些设备到真正的 AI 基础设施,我觉得有三件事值得看。 首先,找到手机适合做的工作。 之前聊过的 Laya,就让手机上的模型处理邮件分类、聊天审核和提示词拦截。这些任务只需要做出一个判断,很适合用来观察手机推理的速度和效果。 演示已经提供 API,可以继续接进应用里测试。不过模型会误判,请求多了也会排队,实际能承担多大工作量,还是要按具体场景验证。 其次,让提供算力的人有理由长期维护设备。 这里就涉及 Staked Compute。提供者质押 $ACU,同时承诺一定的计算能力;如果实际提供的算力低于承诺,可能被罚没部分质押。持币人也可以委托给提供者,但同样承担相应的罚没风险。 当前主网通胀分配中,70% 进入 Staked Compute 奖励池,10% 用于基础 Benchmark 奖励。这个分配能看出,持续提供算力是激励机制的重要部分。 这也让 $ACU 多了一层实际作用:为算力承诺提供抵押。机制能约束提供者,但能否换来稳定服务,还得看设备实际运行情况。 最后,让开发者用起来足够方便。 官方 Deploy Agent 已支持通过 x402,用 Base 上的 USDC 支付并触发任务部署,调用方不用自己管理 ACU 账户,还可以先查询报价。 对我这种做开发的人来说,这个细节挺实际。一个计算网络即使资源很多,接入步骤太复杂,也会让人犹豫。能把付款和部署接进现有程序,才更容易开始尝试。 所以我现在看 Acurast,会把应用、算力承诺和开发者入口放在一起看。Laya 展示手机能做什么,Staked Compute 尝试约束持续供给,部署工具则帮助需求真正进入网络。 我还没亲自完成部署,暂时不能评价稳定性和成本。但这几部分已经让我有了具体的观察方向:任务能否按时完成,费用是否合适,出问题能否方便排查。 几十万部手机接进来,是一个起点。如果开发者试过一个小任务后,愿意把下一个任务也放上去,手机算力才会逐渐成为日常使用的基础设施。 想先看实际效果,可以体验 Laya: 想研究部署和参与方式,可以看官方文档:

♥ 24↻ 03.8k viewsView on X

Pi auto-mode classifier routes tool approvals through Laya or Jev

Pi 插件又燃爆了 🔥 utpalsinghdev 的日常扩展全家桶、alexshpunt 的双区立体视图、deepu105 的自动模式守门员、yangfeng20 的微信遥控枢纽、SuQingLan 的实时账单条……全网玩家把 Pi 玩成了下一代「效率工具箱 + 分屏驾驶舱 + 安全审批官 + 微信遥控器 + 烧钱仪表盘」: 1️⃣ utpalsinghdev/pi-extensions( 作者自己天天在用的 Pi 扩展合集:focus-mode 隐藏工具输出只看对话,prompt-stash 暂存写了一半的提示词,context-window 让 Agent 知道上下文用了多少,remote-workspace 通过 SSH 在远程服务器上改代码、测试、部署,服务器上不用装 Pi;每个扩展单独发 npm。 “一个人的日常工作流,直接抄作业”! 2️⃣ alexshpunt/pi-stereo-view( 把聊天拆成两个区:一边是你和 Agent 的对话,一边是思考、工具调用和 shell 输出;可左右或上下排、调大小、单独放大,连续工具调用自动折叠,每条消息都能一键复制。 “回来一看,再也不忘刚才聊到哪”! 3️⃣ deepu105/pi-automode-classifier( 给 Pi 加上 Claude Code 式的 auto mode:每个工具调用最多过三关——规则(不到 0.1 毫秒)、可选的小分类模型(LANCET 15 毫秒到 Kev 174 毫秒,也能用 Laya 或 Jev)、会话自己的聊天模型,决定放行、问你还是拦截。作者 4 个会话实测:放行的 258 次调用里三关只问了他 4 次(只用 LANCET 要问 19 次),聊天模型调用从 42 次降到 17 次。 “放手让 Agent 跑,危险命令照样拦”! 4️⃣ yangfeng20/pi-wechat-session-hub( 用微信管理本机多个 Pi 会话:微信下发任务,本机 Pi 执行,结果回到微信;后台 daemon 常驻,关掉所有终端也能继续聊,终端里 /resume 自动接管;/last 只读回顾上一轮、不耗 token,授权目录白名单兜底。可见 UI 模式目前依赖 Windows。 “躺床上发条微信,电脑就开工”! 5️⃣ SuQingLan/pi-session-budget( 输入框上方常驻一行:当前会话花了多少钱、用了多少 token、缓存命中率、上下文占压缩阈值多少,还递归把子代理用量一起算进来,按 worker / reviewer 等角色拆小计,支持预算和超预算告警。 “子代理偷偷烧钱?一行字全曝光”!

♥ 24↻ 52.4k viewsView on X

A guide to combining Laya and Jev in a hybrid agent decision system

Jev + Laya + any AI agent is an absolutely insane stack. Jev became one of the most talked-about AI releases almost overnight, but most people still have no idea how to use it beyond isolated demos - especially together with Laya, Grok Bot, Claude Code and Codex. So I mapped the complete architecture into a 12-page guide explaining how to combine all of them into one decision-and-execution system - and the result is genuinely ridiculous: step 1 → stop asking one LLM to do five different jobs: state, judgment, generation, execution and authority should be separate layers step 2 → use Jev as the escalation layer: it handles difficult routing, evidence verification, completion checks and high-consequence decisions through typed answers step 3 → use Laya as the local fast path: it handles frequent classification, scoring, filtering and worker selection without sending every decision to a cloud model step 4 → put both behind one decision gateway: Laya and Jev can accept similar choice, score and yes-or-no questions, but their confidence values need separate thresholds step 5 → keep project state outside the agents: goals, artifacts, evidence, gaps, risks, budgets and approvals become the shared source of truth step 6 → build the worker menu before asking a model to choose: only include agents that exist, are available, have the required tools and are allowed to access the data step 7 → give every executor a different job: Grok Bot handles apps, browsers and routines; Claude Code handles deep repository work; Codex handles implementation, testing and review step 8 → turn every assignment into a bounded packet: one owner, one objective, approved inputs, expected artifacts, forbidden actions and an exact definition of done step 9 → run the hybrid decision loop: Laya answers locally first, Jev receives uncertain or high-risk cases, and a human reviews consequential disagreements step 10 → never average confidence blindly: if Laya and Jev disagree, preserve both distributions, inspect the evidence and route the case through an explicit review policy step 11 → gate effects instead of tool names: reading, searching, testing and drafting can run automatically; publishing, deploying, spending, deleting and exposing secrets still require approval step 12 → test the whole system before giving it autonomy: run shadow mode, measure disagreements, inject failures, test rollback and automate only the safest branches first the result: Laya filters routine decisions, Jev judges difficult boundaries, Grok Bot, Claude Code and Codex execute the work, deterministic code controls the system and you approve the consequences Save this, then send the complete 12-page Jev + Laya + AI Agents guide to your Claude Code or Codex instance and build the stack ↓

♥ 23↻ 1652 viewsView on X

One-click cloud GPU deployment template runs Laya System One

YOU CAN NOW ONE-CLICK DEPLOY YOUR OWN GPU WITH REAL-TIME DECISION AI PRE-INSTALLED @x402_Layer just made Laya available as a template on Singularity AI Machines, letting humans AND AI agents deploy dedicated cloud GPUs with the System One model already configured and ready to run. - Laya System One model available as a template - One-click cloud GPU deployment - Deploy hardware like an RTX 3090 24GB - Humans OR AI agents can launch machines - Laya comes configured for maximum concurrency - Control your own model runtime - Set your own limits

♥ 23↻ 31.5k viewsView on X

Laya races Jev and two LLMs to solve a Rubik’s cube

🚨 Opus 5.5 just won a Rubik’s cube race against GPT-6 Sol, and the two “decision models” didn’t even finish Four players, one cube each, same race. Opus 5.5 solved it first in 1:12.87 with only 3 moves. GPT-6 Sol took the 5:00 limit, made 4 moves and ran out of time. The two decision models, Jev and Laya, burned all 20 of their moves and still left the cube unsolved. Laya burned through them in 9.47 seconds, which is the fastest and the least useful way to fail. Seems like fast hands lose to a slow plan. Opus looked at the cube for over a minute, made 3 moves and was done. Speed or thinking, which would you bet on? 👀

♥ 23↻ 24k viewsView on X

Posted a Laya demo on X? Mention “Laya” and it gets picked up automatically, or submit the project.